Gadające zdjęcie AI - jak sprawić, żeby zdjęcie mówiło
Gadające zdjęcie AI krok po kroku: które modele zamieniają zdjęcie w wideo z mową i ruchem ust, jak wpisać kwestię, koszt klipu w złotówkach, ograniczenia.
 Piotr Olszewski2026-10-027 minEnglish
Gadające zdjęcie AI robisz w modelu "obraz do wideo", który generuje też dźwięk: wgrywasz zdjęcie jako pierwszą klatkę, w prompcie wpisujesz kwestię w cudzysłowie i włączasz dźwięk. W Jantarisie dialog z ruchem ust zsynchronizowanym z mową ma w opisie Kling 3.0 (od 0,98 zł za sekundę bez dźwięku, z dźwiękiem drożej), a zdjęcie z mową i dźwiękiem w cenie dają też Grok Imagine Video 1.5, Vidu Q3 Turbo i MiniMax H3. Niżej porównuję te modele, pokazuję prompt, curl i koszt klipu, a na końcu piszę uczciwie, co z polską mową.
Jak działa gadające zdjęcie AI
Starsze aplikacje "talking photo" animowały samą twarz na zdjęciu pod gotowe nagranie. Nowe modele wideo robią więcej: biorą zdjęcie jako pierwszą klatkę i generują całe ujęcie razem ze ścieżką dźwiękową, czyli głosem, ruchem ust, mimiką, gestami i tłem. Głos nie jest Twój, tylko wymyślony przez model na podstawie opisu ("ciepły kobiecy głos", "niski, spokojny męski głos").
Z tego wynikają dwie rzeczy:
- Kwestię piszesz w prompcie. Model sam ją wypowiada. Nie wgrywasz pliku z mową, chyba że model przyjmuje referencje audio (o tym niżej).
- Zdjęcie ustawia kadr. Proporcje klipu zwykle wynikają z obrazu, więc do rolki 9:16 wgraj pionowe zdjęcie.
Modele, które robią gadające zdjęcie
Dane z katalogu Jantarisa, czyli to, co faktycznie przyjmuje formularz i API:
| Model | Zdjęcie | Dźwięk i mowa | Długość | Cena |
|---|---|---|---|---|
| Kling 3.0 | pierwsza (i ostatnia) klatka | dialog z ruchem ust, po włączeniu generate_audio, za dopłatą | 3-15 s | od 0,98 zł za sekundę |
| Grok Imagine Video 1.5 | dokładnie jedno zdjęcie | zsynchronizowany dźwięk z dialogiem, w cenie | 6-15 s | od 0,509 zł za sekundę |
| Vidu Q3 Turbo | pierwsza klatka | dialog i efekty domyślnie włączone, w cenie | 1-16 s | od 0,468 zł za sekundę |
| MiniMax H3 | pierwsza klatka albo do 9 zdjęć referencyjnych | stereo zawsze, plus do 3 nagrań głosu jako referencja | 4-15 s | od 0,931 zł za sekundę |
| Seedance 2.5 | pierwsza klatka albo do 30 referencji | mowa, efekty i muzyka (mono), referencje audio | 4-30 s | od 1,51 zł za sekundę |
| Wan 3.0 | pierwsza klatka albo do 10 referencji | domyślnie włączony, referencje audio | 2-30 s | od 0,45 zł za sekundę |
Ceny "od" dotyczą najniższej rozdzielczości. Wyraźnie o synchronizacji ruchu ust z mową pisze tylko producent Klinga, dlatego od niego zaczynam. Pozostałe modele generują mowę razem z obrazem, ale tego, jak trzymają usta, nie mierzyłem.
Modelu Veo 3.1 (Quality) tu nie polecam: Google projektuje go z dźwiękiem, ale w Jantarisie formularz Veo nie ma przełącznika dźwięku. MiniMax H3 Max też pomijam, bo jego opis w katalogu nie wymienia ścieżki audio.
Materiał producenta Klinga pokazuje dialog dwóch postaci z natywnym dźwiękiem:
Gadające zdjęcie krok po kroku
- Przygotuj zdjęcie. Twarz dobrze widoczna, en face albo lekko z boku, usta zamknięte lub lekko rozchylone, nic przed buzią (mikrofon, dłoń, kubek). Proporcje takie jak docelowy klip.
- Napisz kwestię. Jedno-dwa krótkie zdania na 5-8 sekund. Dłuższy tekst model przyspiesza albo ucina.
- Opisz głos i ruch. Kto mówi, jakim tonem, co robi kamera. Kamera statyczna albo powolny najazd daje najstabilniejszą twarz.
- Wygeneruj krótko i tanio. Pierwszą próbę robię w najniższej rozdzielczości, a dopiero dobrą wersję w docelowej.
Szablon promptu, który stosuję:
The woman in the photo looks into the camera and says in a warm, calm voice:
"Hi, I'm Anna. Today I'll show you how to repot a cactus without gloves."
Natural head movement and blinking, subtle hand gesture at the end.
Static camera, soft daylight, quiet room tone, no music, no subtitles.
Dopiski "no music" i "no subtitles" mają znaczenie. W moich testach wideo modele potrafiły dołożyć muzykę, o którą nie prosiłem.
W Studio
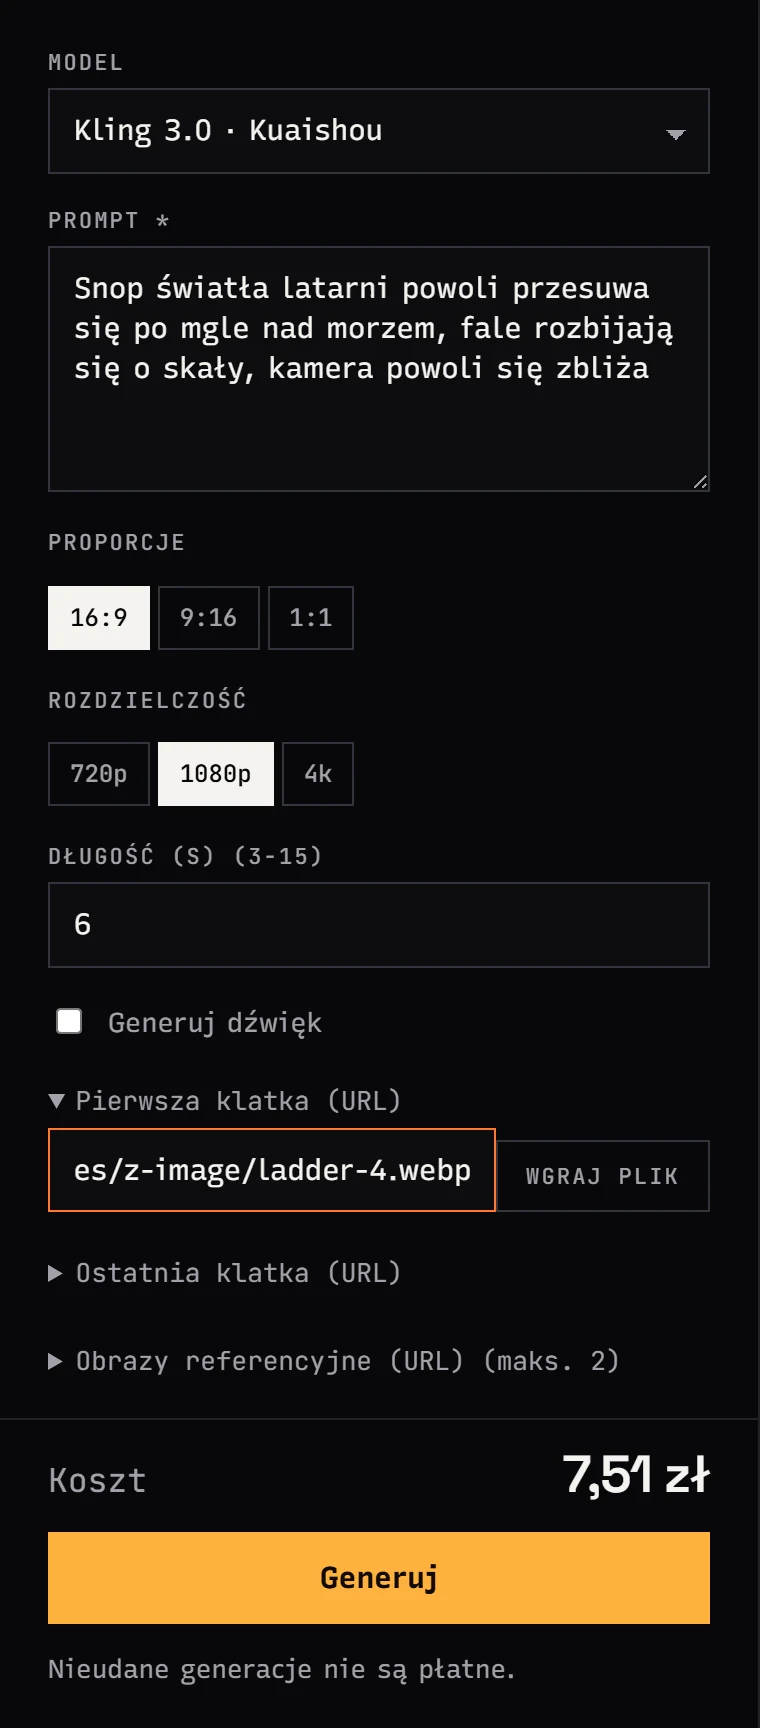
W Jantaris Studio wybierasz zakładkę Wideo i model Kling 3.0. Zdjęcie wgrywasz w pole "Pierwsza klatka" (plik albo adres URL), zaznaczasz "Generuj dźwięk", ustawiasz długość i rozdzielczość. Koszt widać pod formularzem przed kliknięciem Generuj.
Przez API
To samo zlecenie przez API. Pole image_url to pierwsza klatka, a generate_audio: true włącza dialog:
curl https://jantaris.com/v1/generate \
  -H "Authorization: Bearer $JANTARIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "kling-3.0",
    "input": {
      "prompt": "The woman in the photo looks into the camera and says in a warm, calm voice: \"Hi, I am Anna. Today I will show you how to repot a cactus.\" Natural blinking, static camera, quiet room tone, no music, no subtitles.",
      "image_url": "https://twoja-domena.pl/pliki/anna.jpg",
      "duration": 6,
      "resolution": "720p",
      "generate_audio": true
    }
  }'
Odpowiedź zwraca id i estimated_cost, a gotowy plik odbierasz przez GET /v1/tasks/{id}. Jeśli chcesz, żeby postać miała konkretny głos, MiniMax H3 przyjmuje nagranie w audio_urls, ale tylko razem ze zdjęciem albo klipem referencyjnym, np. zdjęciem postaci w image_urls. Do pięciu zdjęć referencyjnych i wszystkie nagrania audio są bez dopłaty. Przykład takiego zapytania jest w tekście MiniMax H3 i Hailuo: cena.
Ile kosztuje gadające zdjęcie
Koszt to sekundy klipu razy stawka. Przykłady dla jednego klipu w najniższej rozdzielczości, z dźwiękiem:
| Model | Klip | Koszt |
|---|---|---|
| Vidu Q3 Turbo, dźwięk w cenie | 8 s | 8 × od 0,468 zł za sekundę |
| Grok Imagine Video 1.5, minimum 6 s | 6 s | 6 × od 0,509 zł za sekundę |
| MiniMax H3 w 768P, stereo w cenie | 6 s | 6 × od 0,931 zł za sekundę |
| Seedance 2.5 w 480p | 5 s | 5 × od 1,51 zł za sekundę |
| Kling 3.0 w 720p z dźwiękiem | 6 s | 6 × stawka z dźwiękiem (bez dźwięku od 0,98 zł za sekundę, z dźwiękiem ok. 1,4 raza więcej) |
Kwota za Klinga jest przybliżona, bo dopłata za dźwięk zależy od rozdzielczości. Dokładną liczbę pokazuje Studio pod formularzem albo pole estimated_cost w odpowiedzi API. Planuj 2-3 podejścia na jedną dobrą kwestię. Nieudane generacje kosztują 0 zł, a saldo doładowujesz od 40 zł BLIK-iem z fakturą VAT. Wszystkie stawki policzysz w kalkulatorze kosztów.
A po polsku?
Tu muszę ostudzić oczekiwania. Polskiego nie ma na oficjalnej liście języków mowy Kling 3.0. W moim teście z 28 września 2026 (u innych dostawców API, nie w Jantarisie) Kling 3.0 w wersji Pro przekręcił 10 z 12 słów trudnego polskiego zdania, choć obraz i ruch ust wyglądały dobrze:

W tym samym teście najlepiej po polsku mówiły MiniMax H3 (jedno błędne słowo na 12) i Grok Imagine Video 1.5 (bez błędu). Szczegóły, tabela wszystkich modeli i sposoby na polskiego lektora są w tekście wideo AI po polsku. Jeśli kwestia może być po angielsku, Kling mówi nim czysto.
Granice i zgoda
- Zgoda osoby ze zdjęcia. Ożywiaj tylko swoje zdjęcia albo zdjęcia osób, które się na to zgodziły. Wideo, w którym ktoś "mówi" słowa, których nie powiedział, może naruszać jego dobra osobiste, a przy podszywaniu się także prawo karne.
- Oznaczenie. Gdy publikujesz takie wideo, napisz, że powstało z AI. Platformy społecznościowe mają własne zasady oznaczania.
- Długie wypowiedzi. 15 sekund to górna granica większości modeli (Seedance 2.5 i Wan 3.0 robią do 30 s). Dłuższą wypowiedź składasz z kilku klipów.
- Zęby i profile. Najwięcej błędów widać przy szerokim uśmiechu, w profilu i przy szybkim ruchu głowy. Kamera statyczna i twarz en face pomagają.
Cały proces ożywiania zdjęć, także bez mowy, opisałem w tekście jak zrobić film AI ze zdjęcia. Przykład producenta PixVerse z dialogiem w scenie (PixVerse V6 też ma opcjonalny dźwięk):
Najczęstsze pytania
Jak sprawić, żeby zdjęcie mówiło?
Wgraj zdjęcie jako pierwszą klatkę w modelu wideo z dźwiękiem (np. Kling 3.0 z włączonym dźwiękiem), wpisz w prompcie kwestię w cudzysłowie i opisz głos. Model wygeneruje klip z mową, mimiką i ruchem ust.
Który model AI robi ruch ust zsynchronizowany z mową?
W katalogu Jantarisa synchronizację ust z mową wprost opisuje Kling 3.0. Grok Imagine Video 1.5, Vidu Q3, MiniMax H3, Seedance 2.5 i Wan 3.0 też generują mowę razem z obrazem.
Czy mogę użyć własnego głosu?
Model sam generuje głos z opisu. MiniMax H3 przyjmuje do 3 nagrań jako referencję głosu, razem ze zdjęciem referencyjnym. Własne nagranie możesz też podłożyć w montażu pod klip bez mowy.
Czy gadające zdjęcie AI mówi po polsku?
Różnie. W moim teście Kling 3.0 mówił po polsku z obcą fonetyką, a MiniMax H3 i Grok Imagine Video 1.5 wypowiedziały trudne zdanie prawie albo całkiem bez błędu. Polską kwestię zawsze sprawdź na jednym krótkim klipie.
Ile kosztuje gadające zdjęcie AI?
Sekundy klipu razy stawka modelu. Na przykład 8 sekund w Vidu Q3 Turbo to 8 × od 0,468 zł za sekundę, z dźwiękiem w cenie. Nieudane generacje kosztują 0 zł.
Czy jest darmowe gadające zdjęcie AI?
W Jantarisie nie ma darmowego planu ani kredytów na start, minimalne doładowanie to 40 zł. Ograniczone darmowe próby mają niektóre aplikacje producentów modeli.