











Jedno API do GPT, Claude, Gemini i DeepSeek - Python i Node
GPT-6, Claude, Gemini i DeepSeek jednym kluczem z Pythona i Node: zmiana modelu jedną linijką, fallback przy błędach i porównanie odpowiedzi z kosztem.
 Piotr Olszewski2026-10-026 minEnglish
Do GPT, Claude, Gemini i DeepSeek wystarczy jeden klient i jeden klucz: oficjalne SDK OpenAI z adresem https://jantaris.com/v1 obsługuje wszystkie 22 modele czatu z katalogu Jantarisa, a model zmieniasz jedną linijką, np. z gpt-6-sol na claude-sonnet-5 albo deepseek-v4.1-flash. Płacisz w złotówkach z jednego salda, z fakturą VAT. Poniżej działający kod w Pythonie i Node: przełączanie modelu z konfiguracji, fallback przy awarii i porównanie odpowiedzi kilku modeli z czasem i kosztem w złotówkach.
Dlaczego jedno API zamiast czterech SDK
Każdy producent ma własne SDK, własny format wiadomości, własne błędy i własne konto z płatnością w dolarach. Obsługa czterech producentów to cztery ścieżki w kodzie, cztery klucze i cztery faktury z zagranicy.
Jantaris wystawia jeden endpoint w formacie OpenAI (/v1/chat/completions) dla wszystkich modeli czatu i drugi w formacie Anthropic (/v1/messages) dla modeli Claude. Dla kodu model staje się zwykłym napisem w konfiguracji. Dla księgowości to jedno saldo w złotówkach i krajowa faktura VAT po każdym doładowaniu.
| Model (przykłady) | Id | Cena za 1 mln tokenów (wejście / wyjście) |
|---|---|---|
| GPT-6 Sol | gpt-6-sol | 11,75 zł / 58,75 zł za 1 mln tokenów |
| Claude Sonnet 5 | claude-sonnet-5 | 17,62 zł / 88,12 zł za 1 mln tokenów |
| gemini-3.8-flash | gemini-3.8-flash | |
| DeepSeek V4.1 Flash | deepseek-v4.1-flash | 2,94 zł / 9,55 zł za 1 mln tokenów |
| GPT-6 Luna | gpt-6-luna | 0,587 zł / 2,94 zł za 1 mln tokenów |
Pełna lista, z GLM, Kimi, Qwen, MiniMax i Grokiem, jest w katalogu modeli i pod GET /v1/models?category=chat.
Krok 1: klucz i instalacja
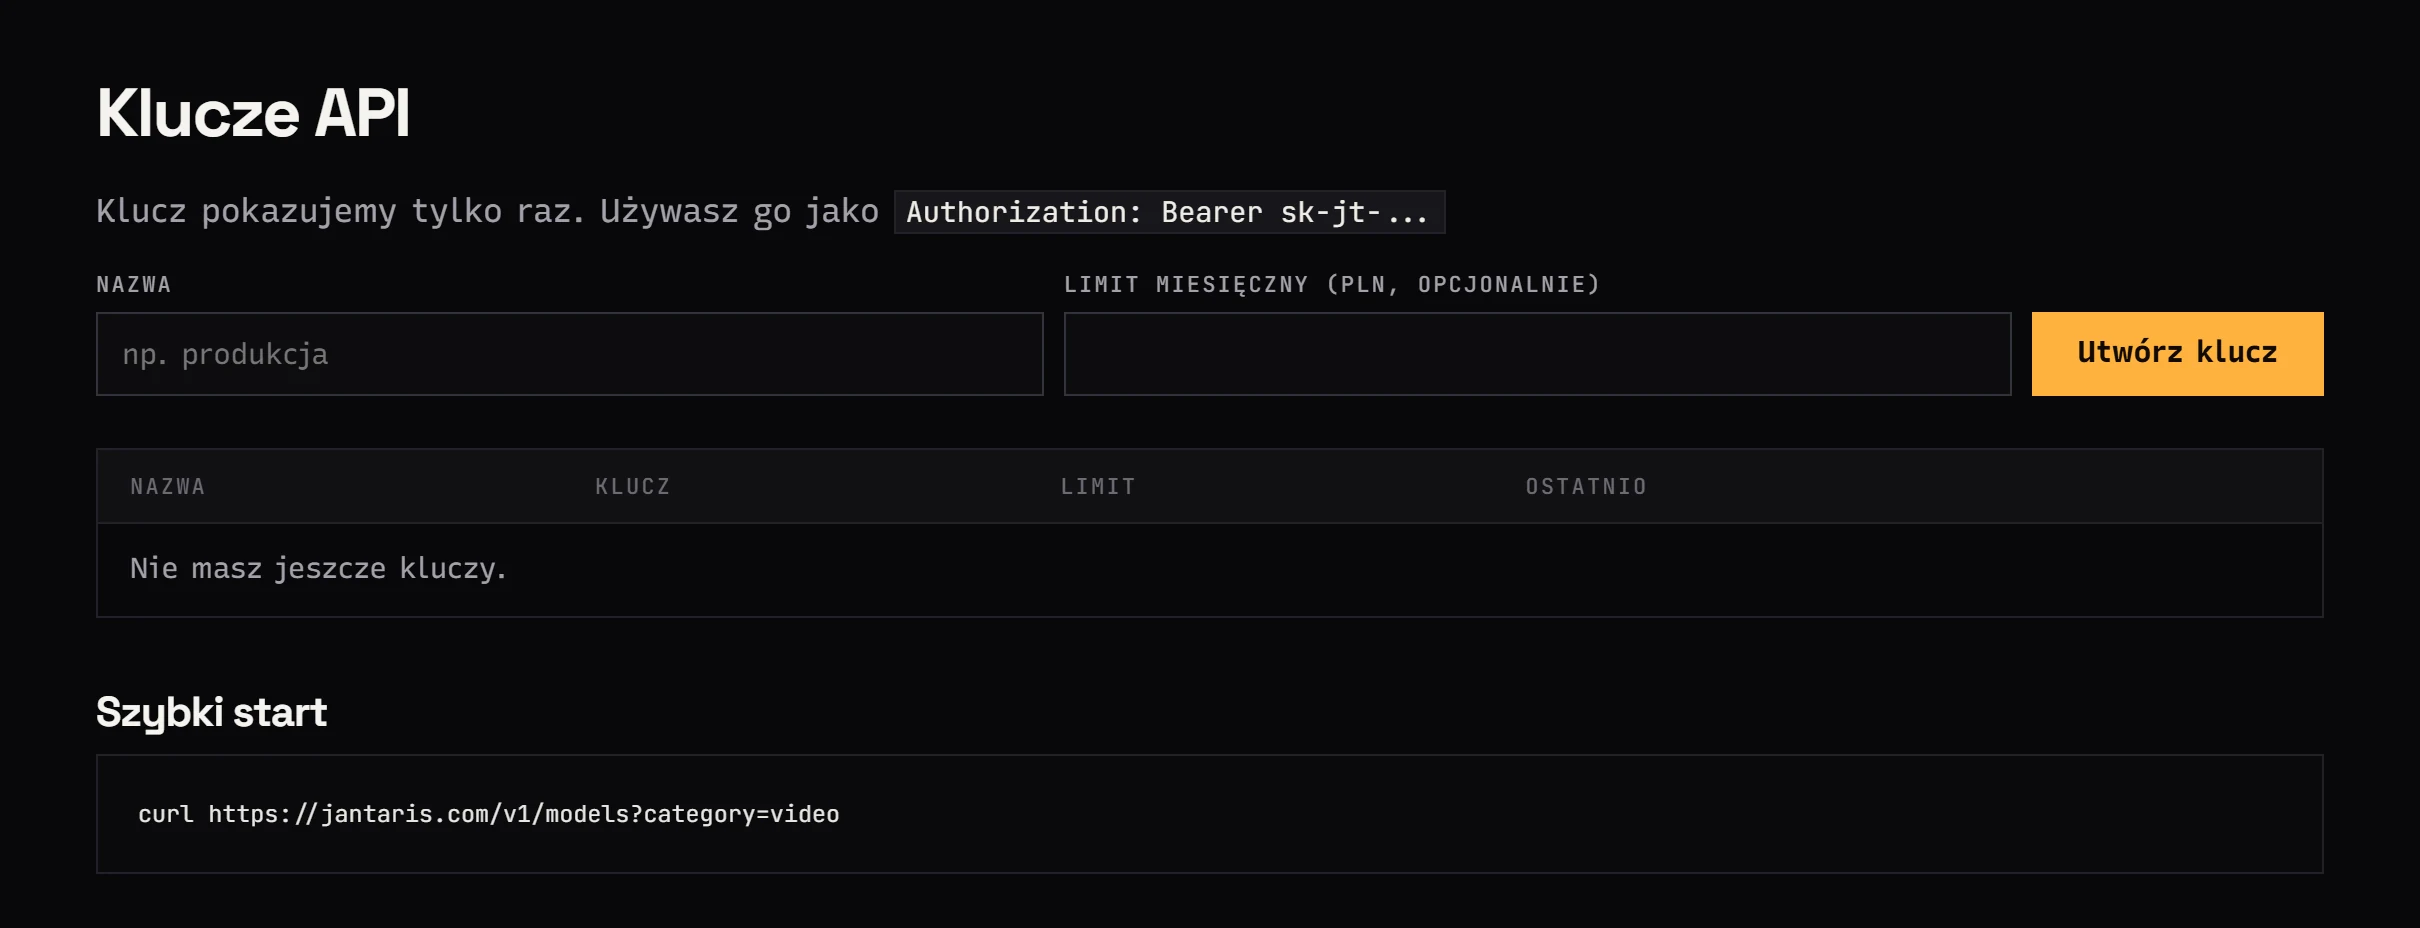
- Załóż konto na stronie rejestracji i doładuj saldo (BLIK, od 40 zł).
- W panelu utwórz klucz API i ustaw mu limit miesięczny. Klucz
sk-jt-...pokazuje się tylko raz. - Zapisz klucz w zmiennej środowiskowej, nie w kodzie.
pip install openai requests
export JANTARIS_API_KEY=sk-jt-...
export LLM_MODEL=gpt-6-sol
W PowerShellu: $env:JANTARIS_API_KEY = "sk-jt-...".
Zmiana modelu jedną linijką
Najprostsza wersja: model czytasz ze zmiennej środowiskowej, więc przełączasz go bez dotykania kodu.
import os
from openai import OpenAI

client = OpenAI(base_url="https://jantaris.com/v1", api_key=os.environ["JANTARIS_API_KEY"])
MODEL = os.environ.get("LLM_MODEL", "gpt-6-sol")

def ask(prompt: str, model: str = MODEL) -> str:
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "Odpowiadasz po polsku, konkretnie."},
            {"role": "user", "content": prompt},
        ],
    )
    return resp.choices[0].message.content

print(ask("Czym różni się PUT od PATCH w REST?"))
print(ask("Czym różni się PUT od PATCH w REST?", model="claude-sonnet-5"))
LLM_MODEL=deepseek-v4.1-flash python app.py i ten sam program działa na DeepSeeku. Streaming (stream=True) i narzędzia (tools) mają identyczny format dla wszystkich modeli, opisałem je w dokumentacji czatu.
Porównanie odpowiedzi kilku modeli z kosztem
Zanim wybiorę model do projektu, puszczam te same pytania przez kilka modeli naraz i patrzę na trzy rzeczy: jakość odpowiedzi, czas i koszt. Ceny biorę z publicznego GET /v1/models (w złotówkach z VAT), a zużycie z pola usage każdej odpowiedzi.
import os, time
from concurrent.futures import ThreadPoolExecutor

import requests
from openai import OpenAI

BASE = "https://jantaris.com/v1"
client = OpenAI(base_url=BASE, api_key=os.environ["JANTARIS_API_KEY"])

catalog = requests.get(f"{BASE}/models", params={"category": "chat", "currency": "PLN"}, timeout=30).json()["data"]
PRICES = {m["id"]: m["pricing"] for m in catalog}

MODELS = ["gpt-6-sol", "claude-sonnet-5", "gemini-3.8-flash", "deepseek-v4.1-flash"]
PROMPT = "Klient pisze: 'Paczka nie dotarła od 6 dni'. Napisz uprzejmą odpowiedź w 3 zdaniach."

def run(model):
    t0 = time.perf_counter()
    r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": PROMPT}])
    u, p = r.usage, PRICES[model]
    cost = (u.prompt_tokens * float(p["input_per_mtok"]) + u.completion_tokens * float(p["output_per_mtok"])) / 1_000_000
    return model, time.perf_counter() - t0, u.prompt_tokens, u.completion_tokens, cost, r.choices[0].message.content

with ThreadPoolExecutor(max_workers=len(MODELS)) as pool:
    results = list(pool.map(run, MODELS))

for model, sec, tin, tout, cost, text in sorted(results, key=lambda x: x[4]):
    print(f"\n=== {model} | {sec:.1f} s | {tin} + {tout} tokenów | {cost:.4f} zł")
    print(text)
Wynik jest posortowany od najtańszej odpowiedzi. Kilka uwag z praktyki:
- jedno pytanie niczego nie dowodzi, do decyzji biorę 20-50 prawdziwych przykładów z projektu,
- liczba tokenów wyjścia u modeli rozumujących obejmuje myślenie, więc krótka odpowiedź potrafi mieć sporo tokenów,
- ten sam tekst to różna liczba tokenów w różnych modelach, dlatego porównuję koszt całego zapytania, a nie stawki.
Jak wygląda ranking samych stawek na przykładzie 1000 odpowiedzi czatu, pokazałem w tekście Najtańsze API LLM 2026.
Fallback: gdy model nie odpowiada
Każdy producent ma czasem gorszy dzień. Część modeli w Jantarisie ma automatyczny failover między dostawcami infrastruktury, ale warto dołożyć drugą warstwę w kodzie: przejście na inny model. Ważne, żeby nie przełączać się przy błędach, których zmiana modelu nie naprawi.
import time
from openai import APIStatusError, APIConnectionError

CHAIN = ["claude-sonnet-5", "gpt-6-sol", "gemini-3.8-flash"]
NO_RETRY = {401, 402, 403, 422}  # klucz, saldo, limit klucza, błędne parametry

def ask_with_fallback(messages, **kw):
    last = None
    for model in CHAIN:
        for attempt in range(2):
            try:
                r = client.chat.completions.create(model=model, messages=messages, **kw)
                return model, r.choices[0].message.content
            except APIStatusError as e:
                if e.status_code in NO_RETRY:
                    raise
                last = e
                if e.status_code == 404:
                    break  # nieznany model - od razu następny w łańcuchu
                time.sleep(2 * (attempt + 1))  # 429 i 5xx: chwila przerwy, potem następna próba
            except APIConnectionError as e:
                last = e
                time.sleep(2 * (attempt + 1))
    raise last

model, answer = ask_with_fallback([{"role": "user", "content": "Streść RODO w 5 punktach."}])
print(f"[{model}] {answer}")
Co oznaczają kody w tym kontekście:
| Kod | Znaczenie | Przełączać model? |
|---|---|---|
| 401 | zły albo usunięty klucz | nie |
| 402 | za niskie saldo | nie, doładuj |
| 403 | klucz doszedł do limitu miesięcznego | nie, podnieś limit w panelu |
| 404 | model nie istnieje | tak, i popraw id |
| 422 | błędne parametry | nie, popraw zapytanie |
| 429 | limit zapytań | tak, po krótkiej przerwie |
| 502 | błąd po stronie dostawcy | tak |
Zapytanie, które się nie powiedzie, nie jest płatne, więc ponowienie po błędzie nie kosztuje podwójnie. Pełna lista błędów: dokumentacja błędów.
To samo w Node.js
npm install openaiimport OpenAI from "openai";
const BASE = "https://jantaris.com/v1";
const client = new OpenAI({ baseURL: BASE, apiKey: process.env.JANTARIS_API_KEY });
const res = await fetch(`${BASE}/models?category=chat¤cy=PLN`);
const prices = Object.fromEntries((await res.json()).data.map((m) => [m.id, m.pricing]));
const models = ["gpt-6-luna", "claude-haiku-4.5", "deepseek-v4.1-flash"];
const prompt = "Podaj 3 pomysły na nazwę kawiarni przy dworcu.";
const results = await Promise.allSettled(
models.map(async (model) => {
const r = await client.chat.completions.create({ model, messages: [{ role: "user", content: prompt }] });
const p = prices[model];
const cost = (r.usage.prompt_tokens * Number(p.input_per_mtok) + r.usage.completion_tokens * Number(p.output_per_mtok)) / 1e6;
return { model, cost: cost.toFixed(4) + " zł", text: r.choices[0].message.content };
}),
);
for (const r of results) console.log(r.status === "fulfilled" ? r.value : r.reason.message);Promise.allSettled sprawia, że błąd jednego modelu nie przerywa porównania pozostałych. Zwróć uwagę na nazwę opcji: w Node to baseURL, w Pythonie base_url.
Kiedy zostać przy SDK Anthropic
Jeśli masz kod napisany pod SDK Anthropic (np. z blokami tool_use albo z prompt cachingiem), nie musisz go przepisywać. Endpoint /v1/messages obsługuje modele Claude w oryginalnym formacie:
from anthropic import Anthropic

claude = Anthropic(base_url="https://jantaris.com", api_key=os.environ["JANTARIS_API_KEY"])
msg = claude.messages.create(
    model="claude-opus-5.5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Zaproponuj schemat tabel dla systemu rezerwacji sal."}],
)
print(msg.content[-1].text)
Adres dla SDK Anthropic podajesz bez /v1. Ten endpoint obsługuje tylko modele Claude. Kiedy w jednej aplikacji mieszasz Claude z GPT i Gemini, prościej trzymać wszystko w formacie OpenAI. Szczegóły kosztów i cache Claude opisałem w tekście Claude Opus 5.5 i Sonnet 5 przez API.
Pułapki przy przełączaniu modeli
Format jest wspólny, ale modele nie są identyczne. Na to trafiam najczęściej:
temperatureitop_p. Claude Sonnet 5 odrzuca niestandardowe wartości błędem 400, a OpenAI podaje, że GPT-6 Astra też ich nie przyjmuje. Jeśli zapytanie ma działać na każdym modelu, nie ustawiaj tych parametrów.max_tokensu modeli rozumujących. Myślenie zużywa część limitu wyjścia, więc za niski limit kończy się uciętą albo pustą odpowiedzią. Na starcie nie ustawiaj go wcale albo daj zapas.- Limity odpowiedzi. Gemini 3.6 Flash ma w Jantarisie limit 8192 tokenów odpowiedzi, Claude Haiku 4.5 kontekst 200 tys. tokenów zamiast 1 mln. Sprawdzisz to w
GET /v1/models(polacontext_windowimax_output_tokens). - Styl odpowiedzi. Ten sam prompt systemowy daje u różnych modeli różną długość i ton. Po zmianie modelu przejrzyj kilkanaście odpowiedzi, zanim puścisz go na produkcję.
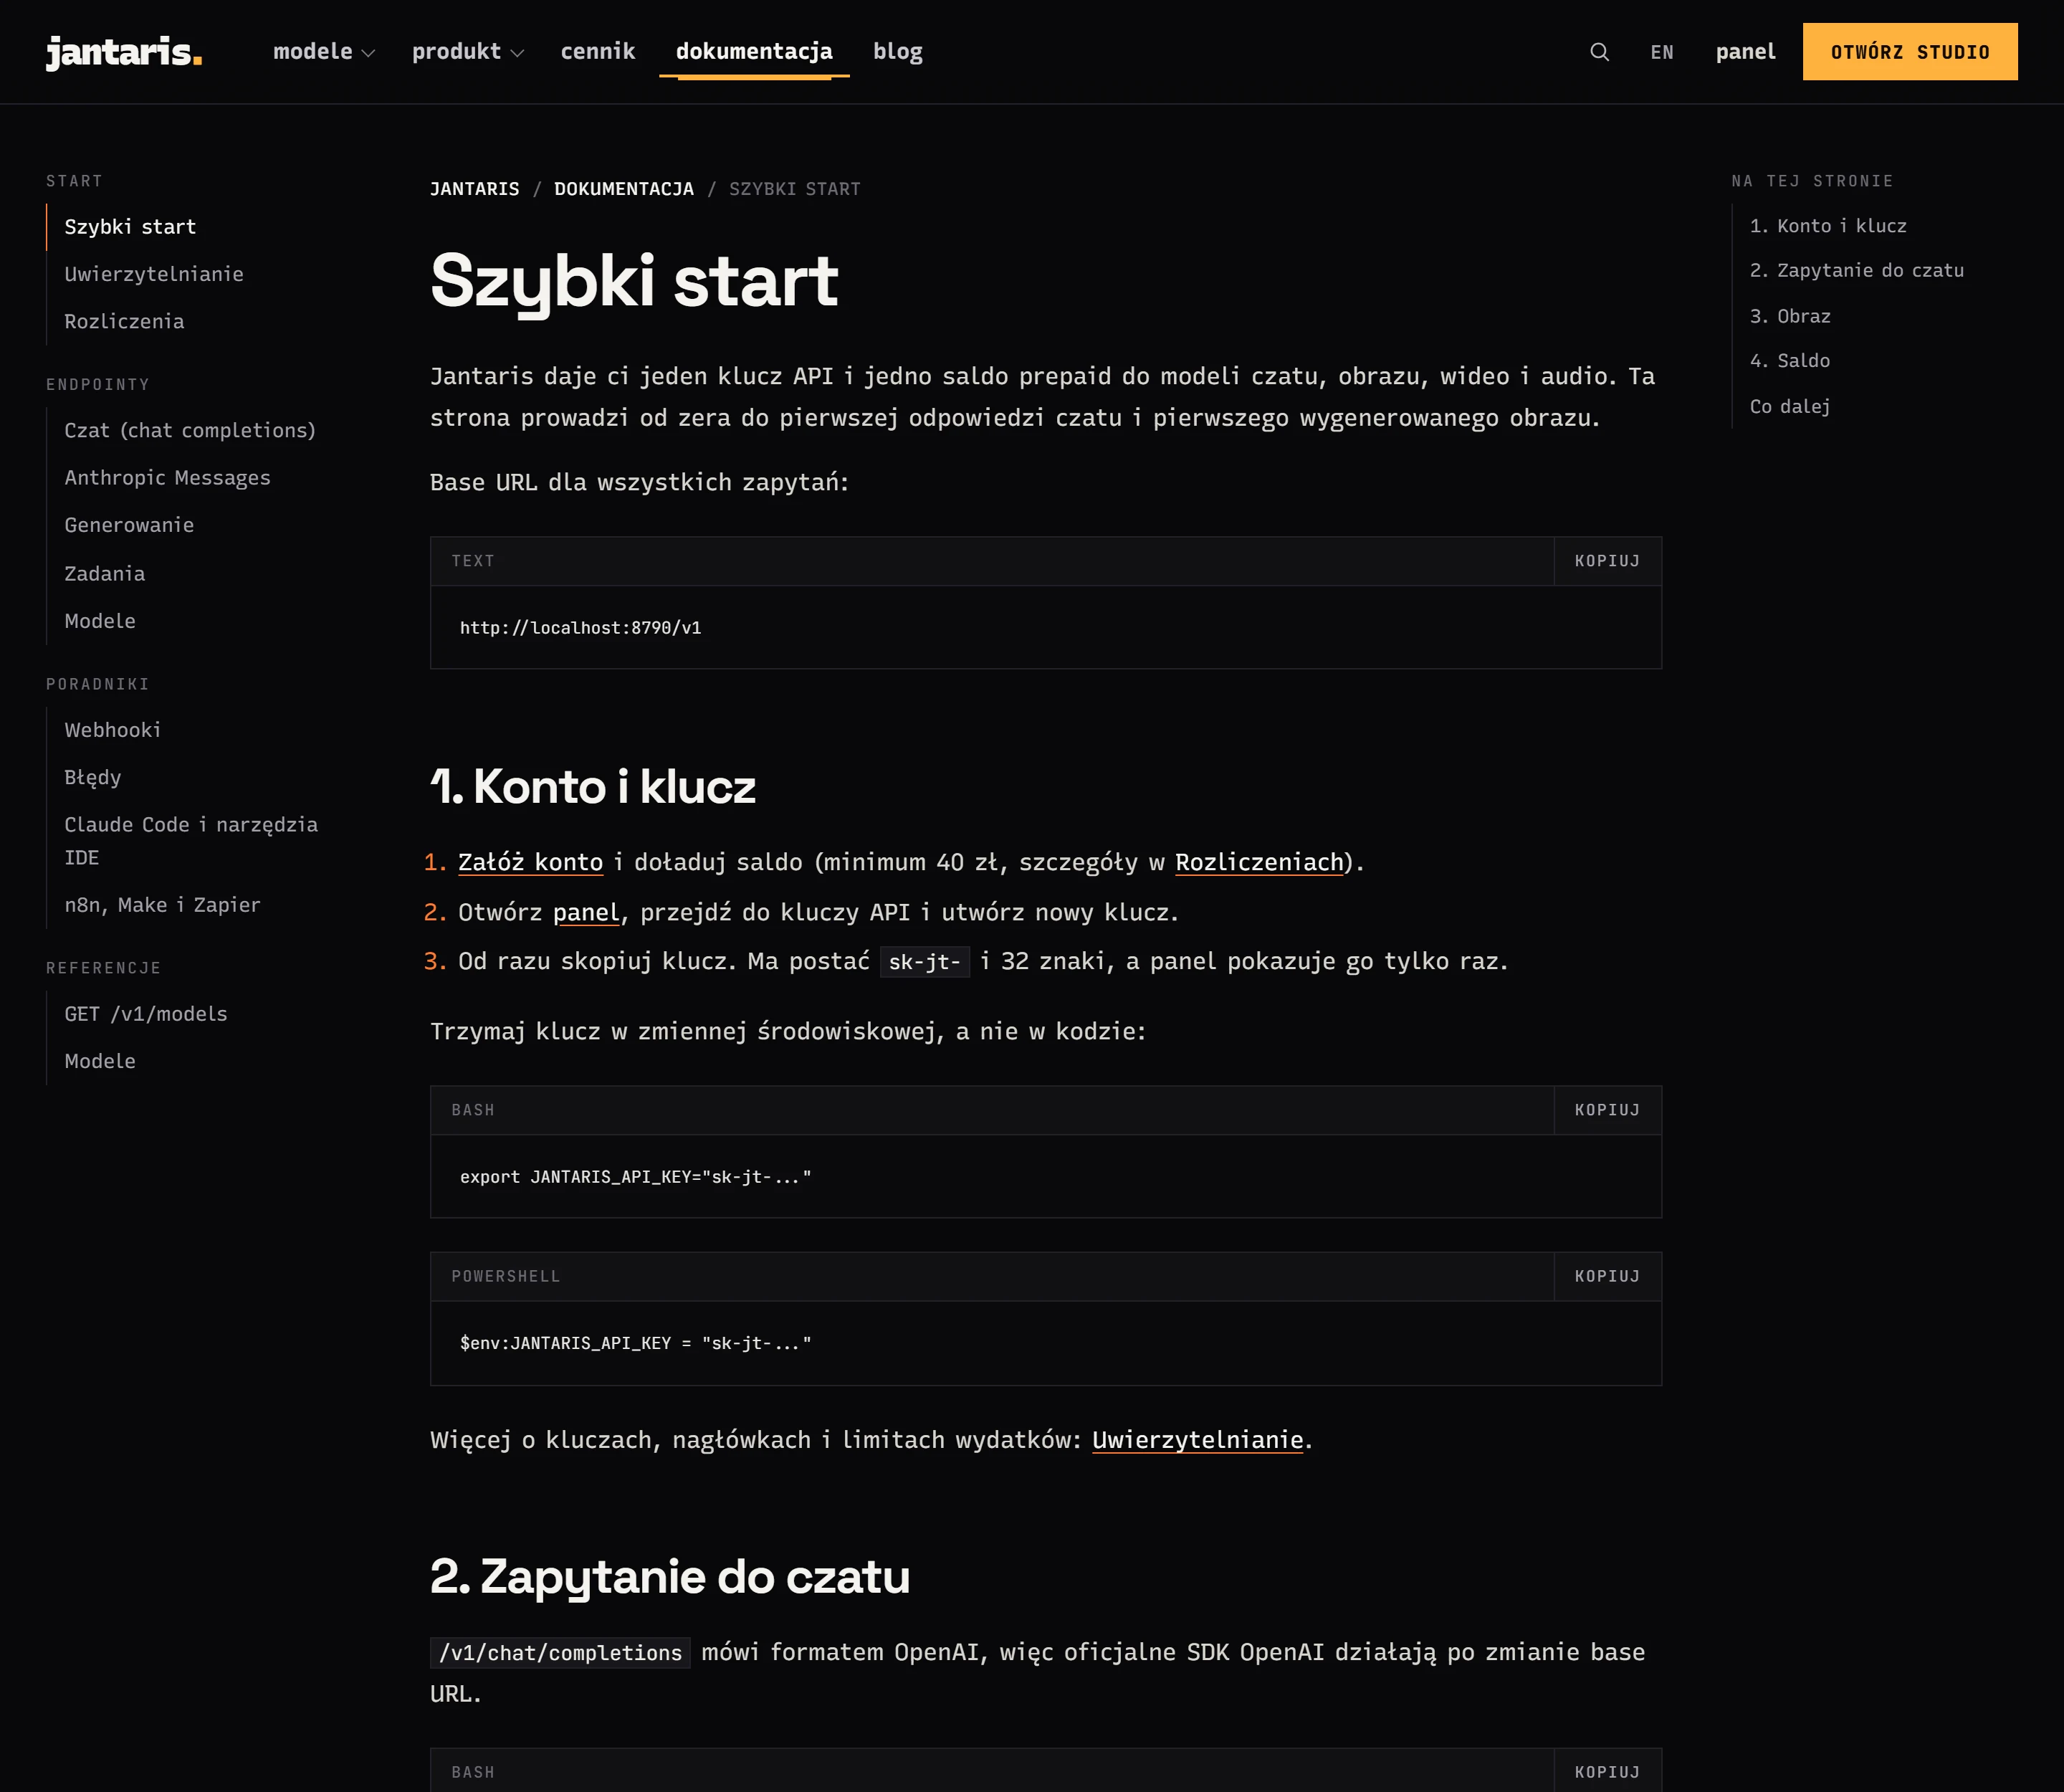
Jeśli zamiast pisać kod wolisz narzędzia no-code, ten sam klucz działa w n8n, Make i Zapierze (adres https://jantaris.com/v1) - instrukcja jest w dokumentacji no-code. Ceny poszczególnych modeli GPT-6 rozpisałem w tekście GPT-6 API cena.
Najczęstsze pytania
Czy mogę wołać Claude i Gemini przez SDK OpenAI?
Tak. Ustaw base_url="https://jantaris.com/v1", klucz sk-jt-... i model, np. claude-sonnet-5 albo gemini-3.8-flash. Format zapytania i odpowiedzi to standardowe Chat Completions, razem ze streamingiem i narzędziami.
Jak przełączyć model bez zmiany kodu?
Trzymaj id modelu w zmiennej środowiskowej albo pliku konfiguracyjnym i przekazuj go do model. Zmiana z gpt-6-sol na deepseek-v4.1-flash to wtedy zmiana jednej wartości.
Jak zrobić fallback między modelami?
Złap błędy 429, 5xx i błędy połączenia, a potem spróbuj kolejnego modelu z listy. Nie przełączaj się przy 401, 402, 403 i 422, bo to problem z kluczem, saldem, limitem albo parametrami. Kod jest wyżej w tekście.
Ile kosztuje porównanie kilku modeli?
Tyle, ile tokenów zużyją wszystkie zapytania razem, według stawek każdego modelu. Skrypt z tego tekstu liczy koszt każdej odpowiedzi w złotówkach na podstawie usage i cen z GET /v1/models.
Czy potrzebuję osobnych kont u OpenAI, Anthropic i Google?
Nie. Jeden klucz Jantarisa i jedno saldo w złotówkach obsługują wszystkie modele z katalogu, także obraz, wideo i muzykę. Fakturę VAT dostajesz po każdym doładowaniu.
Czy to działa z Node.js i TypeScriptem?
Tak, z oficjalnym pakietem openai dla Node. W konstruktorze podajesz baseURL: "https://jantaris.com/v1" i klucz, reszta kodu jest taka sama jak przy API OpenAI.


