Spójna postać AI - ta sama twarz w wielu ujęciach i wideo
Jak utrzymać tę samą postać w obrazach i wideo AI: portret wzorcowy, obrazy referencyjne, pierwsza klatka, stały opis i seed. Limity modeli i moje testy.
 Piotr Olszewski2026-10-029 minEnglish
Tę samą postać w wielu ujęciach dostajesz z obrazu, nie z opisu. Generujesz raz portret wzorcowy, a potem podajesz go modelowi jako referencję w image_urls (do obrazów) albo jako pierwszą klatkę w image_url (do wideo). Sam prompt, nawet bardzo dokładny, daje w najlepszym razie brata bohatera: w moim teście dziesięciu modeli rekwizyty trzymały się wszędzie, a twarz już nie. Niżej pokazuję, skąd ten dryf, jak ułożyć pracę krok po kroku, ile referencji przyjmuje każdy model w Jantarisie i czego żaden z nich nie gwarantuje.
Dlaczego twarz się zmienia
Model nie pamięta poprzedniego obrazu. Każda generacja zaczyna się od losowego szumu (seeda), a prompt tylko zawęża, co z tego szumu wyjdzie. Wszystko, czego opis nie przesądza, model dobiera na nowo.
Widać to na moim lokalnym teście Z-Image Turbo: ten sam prompt, trzy seedy.
portrait of a fisherman in a yellow raincoat on a pier, overcast light, 85mm lens, realistic skin texture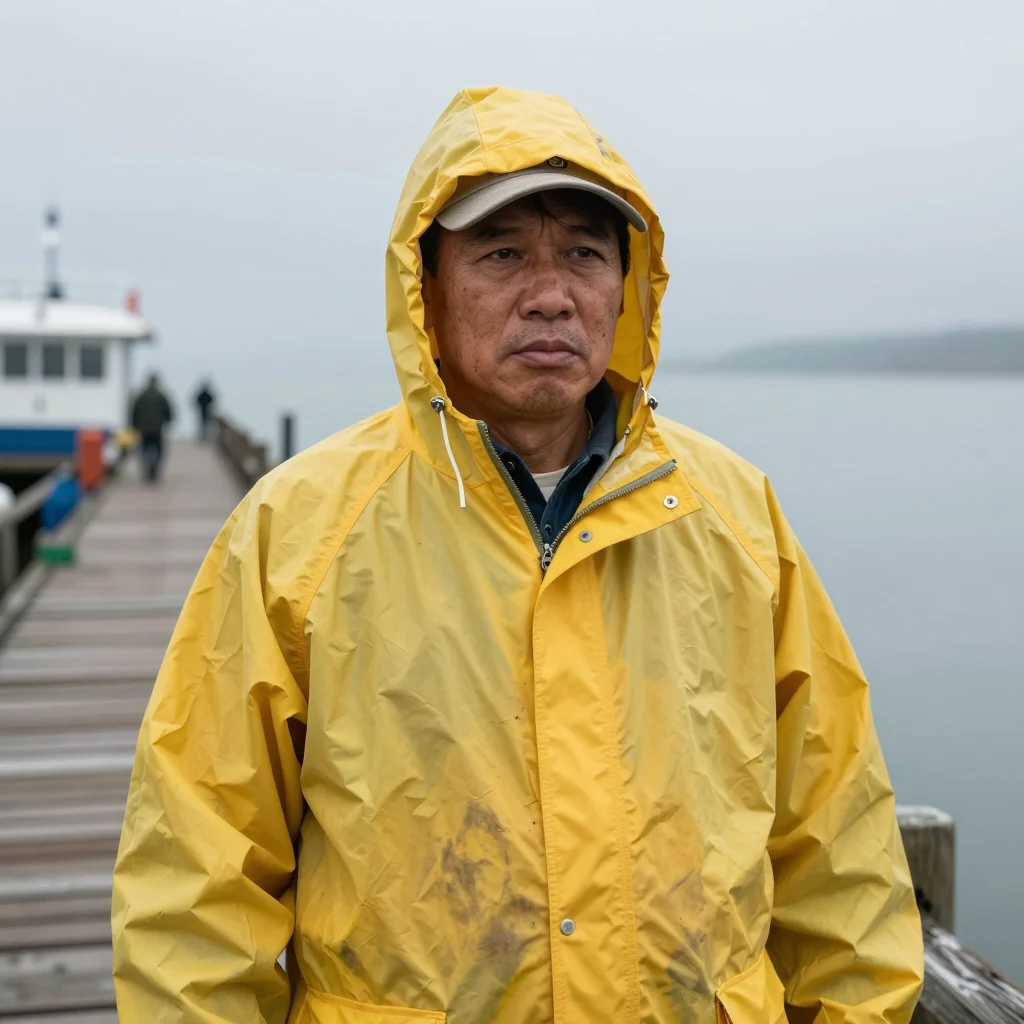

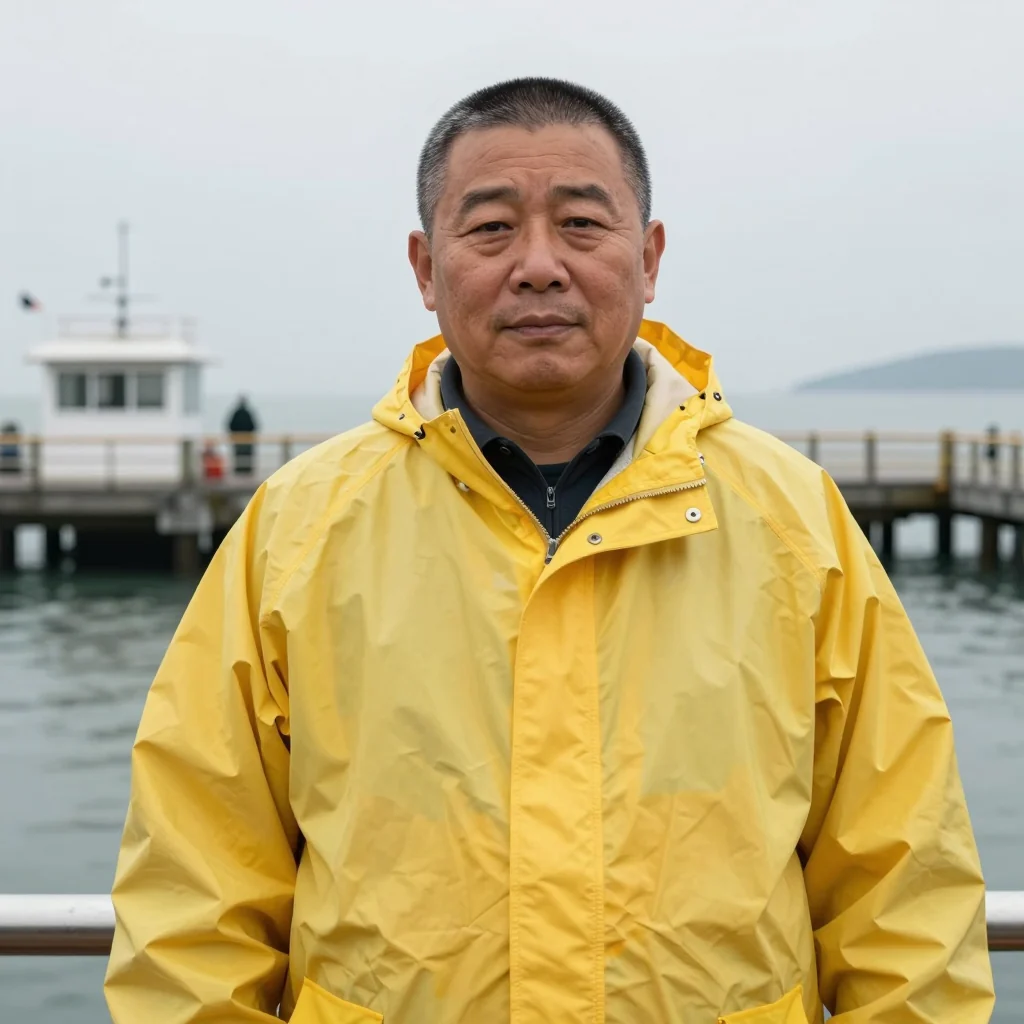
Opis został spełniony trzy razy: żółty płaszcz, pomost, pochmurne światło. Ale to trzech różnych mężczyzn. Inny owal twarzy, inny wiek, inne włosy. Wspólny jest tylko typ, który model wybrał sam, bo prompt nie mówił nic o wyglądzie. Tak działa każdy generator: opis ustala kategorię, a konkretną twarz losuje.
Test: 10 modeli, jeden bohater, 4 sceny
W czerwcu 2026 na promptowy.com dałem dziesięciu modelom tego samego bohatera: Marek, 35 lat, krótka ciemna broda, okrągłe okulary, rozczochrane brązowe włosy, musztardowy sweter. Cztery sceny (kawiarnia, rower, biuro, deszcz nocą), ten sam opis i ten sam seed, bez żadnego obrazu referencyjnego. Pełne plansze są w tekście Czy AI utrzyma tę samą twarz?.
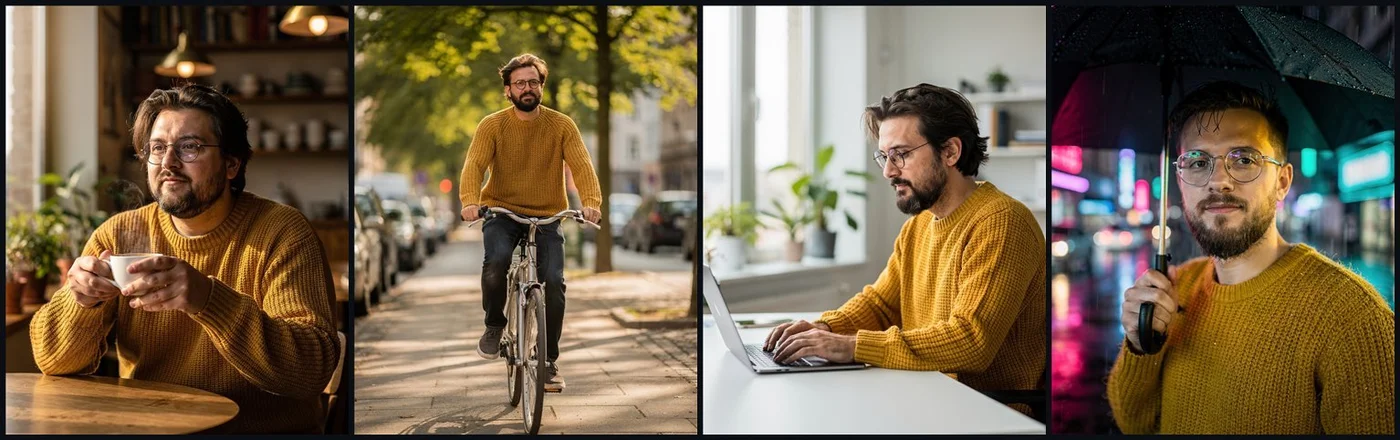
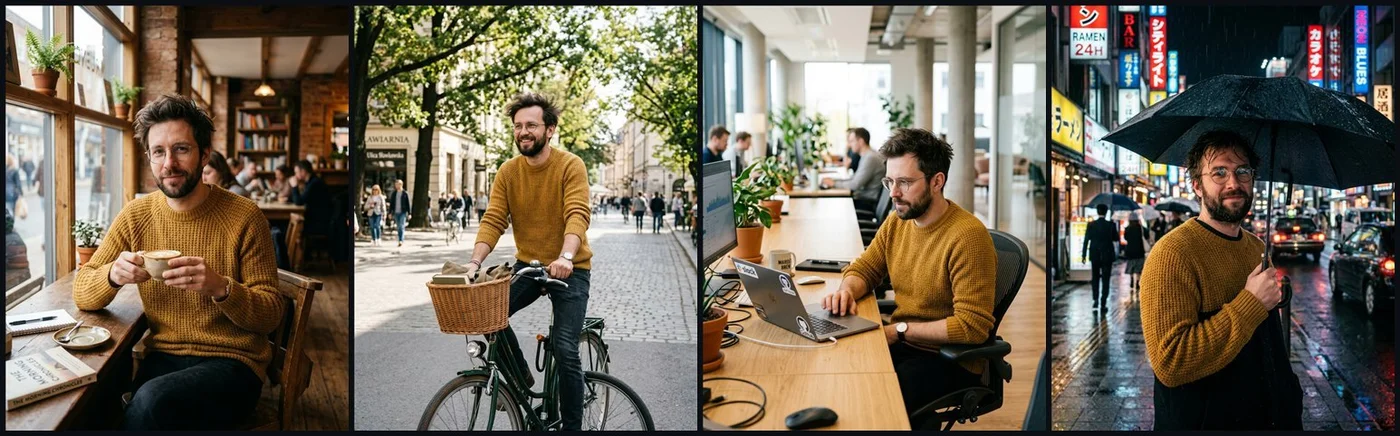
Co z tego wyszło:
- Rekwizyty trzymały wszystkie modele. Okulary, broda, sweter i fryzura nie znikały między scenami. Spójność "typu postaci" jest rozwiązana.
- Twarz to inna sprawa. Najlepiej trzymał ją Seedream 4.5, tuż za nim Photon i FLUX.2 [pro]. GPT Image 2 lekko dryfował w scenie deszczowej.
- Nano Banana 2 wypadł najsłabiej, choć to model reklamowany spójnością. W kawiarni, na rowerze i w deszczu wyglądał jak trzech różnych ludzi w jednym swetrze.
Wniosek: opis daje podobnego człowieka, a nie tego samego. Do tego potrzebna jest referencja.
Metoda w czterech krokach
1. Portret wzorcowy
Najpierw robię jeden obraz, który będzie źródłem prawdy o postaci. Najlepiej "arkusz postaci": twarz z przodu, z profilu i cała sylwetka na neutralnym tle, w równym świetle. Model wideo i model obrazu dostaną potem dokładnie ten wygląd.
Character sheet of the same man on a plain light grey background, even studio light:
front close-up, left profile close-up, full body standing. 35 years old,
short dark beard, round thin metal glasses, messy brown hair, mustard knitted sweater,
dark jeans, white sneakers. Realistic photo, no text.
Do tego kroku biorę model, który robi najlepsze twarze, np. Nano Banana Pro (od 0,439 zł za obraz). Generuję kilka wersji i wybieram jedną. Od tej chwili jej nie zmieniam.
2. Stały opis postaci
Ten sam blok tekstu wklejam do każdego promptu, słowo w słowo. Nie "brodaty facet w okularach" raz, a "mężczyzna z zarostem" drugi raz. Każda zmiana słowa to dla modelu nowa wskazówka. Postaci nadaję imię i opisuję tylko to, co ma się nie zmieniać: wiek, twarz, włosy, strój. Zmienną część promptu (scena, akcja, światło) piszę osobno.
3. Sceny z referencją (obrazy)
Portret wgrywam w pole image_urls (w Studio: Obrazy referencyjne (URL), przycisk Wgraj plik) i w prompcie mówię, kim jest osoba z obrazu:
curl "https://jantaris.com/v1/generate?wait=60" \
  -H "Authorization: Bearer $JANTARIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-pro",
    "input": {
      "prompt": "The man from the reference image, same face, beard, glasses, hair and mustard sweater. He rides a bicycle down a tree-lined street in autumn, late afternoon sun, 50mm lens, realistic photo.",
      "image_urls": ["https://example.com/marek-arkusz.png"],
      "aspect_ratio": "16:9",
      "resolution": "1k"
    }
  }'
Ustawiam proporcje wprost, bo Nano Banana Pro bez nich przejmuje format pierwszej referencji. Każdą scenę porównuję z portretem: oczy, nos, linia szczęki.
4. Wideo: pierwsza klatka albo referencje
Do wideo mam dwie drogi:
- Pierwsza klatka (
image_url). Scena z kroku 3 staje się początkiem klipu, a w prompcie opisuję tylko ruch. Najbezpieczniejsza droga, bo pierwsza sekunda jest dokładnie Twoim obrazem. Szczegóły w tekście jak zrobić film AI ze zdjęcia. - Obrazy referencyjne (
image_urls). Model buduje nową scenę od zera, ale z wyglądem postaci z obrazów. Daje więcej swobody kadru, za to mniej pewności.
Sprawdziłem drugą drogę we wrześniu 2026 na Kling 3.0 Omni (przez inne API, w Jantarisie tego trybu Klinga nie ma). Referencją była klatka kobiety przy kuchennym stole z mojego wcześniejszego klipu, a prompt kazał jej wstać, podejść do okna i powiedzieć jedno zdanie. Wygląd, fryzura i sweter zgadzały się z referencją, a model wykonał całą akcję. Minus: zdanie padło, gdy stała tyłem do kamery, więc ruchu ust nie dało się ocenić. Opis testu jest w tekście o Kling 4.0 Omni Reference.
Ile referencji przyjmuje który model
Limity z katalogu Jantarisa. Model obrazu wybierasz do portretu i scen, model wideo do ruchu.
| Model | Typ | Obrazy referencyjne | Pierwsza klatka | Seed |
|---|---|---|---|---|
| GPT Image 2.5 | obraz | do 16 | - | nie |
| Nano Banana Pro | obraz | do 14 | - | nie |
| Nano Banana 2 | obraz | do 14 (zalecane do 4 referencji postaci) | - | nie |
| Seedream 5.0 Pro | obraz | do 10 | - | nie |
| FLUX.2 [pro] | obraz | do 8 | - | nie |
| FLUX.1 Kontext [pro] | obraz | do 4 | - | tak |
| Seedance 2.5 | wideo | do 30 | tak | tak |
| Wan 3.0 | wideo | do 10 | tak | tak |
| MiniMax H3 | wideo | do 9 | tak | nie |
| HappyHorse 1.1 | wideo | do 9 | tak | nie |
| PixVerse V6 | wideo | do 7 | tak | tak |
| Kling 3.0 | wideo | - | tak (plus ostatnia klatka) | nie |
Kilka uwag z opisów modeli:
- W HappyHorse 1.1 do referencji odwołujesz się w prompcie jako
[Image 1],[Image 2]. W Wan 3.0 nazywasz je "Image 1", "Video 1", a w przykładzie ByteDance dla Seedance 2.5 pada "@Video 1". Taka etykieta pomaga, gdy postaci jest kilka. - W MiniMax H3 obrazy od szóstego do dziewiątego są liczone dodatkowo.
- Seedance 2.5 według opisu przyjmuje referencje z prawdziwymi ludźmi. Część innych modeli ma filtry, które odrzucają realne twarze. Takie odrzucone zadanie w Jantarisie kosztuje 0 zł.
Seedance 2.5 umie też przedłużyć gotowy klip z zachowaniem postaci, co jest kolejnym sposobem na spójność w dłuższej scenie:
Ruch z nagrania: Motion Control
Gdy postać ma wykonać konkretny ruch (taniec, gest, chód), Kling 3.0 Motion Control bierze zdjęcie postaci (image_url) i Twoje nagranie ruchu (video_url). Wygląd idzie ze zdjęcia, ruch z wideo. Płacisz 1,44 zł za sekundę, liczone od długości nagrania źródłowego.
Seed: co daje, a czego nie
Seed przydaje się, ale nie do tego, o co ludzie zwykle pytają. Ten sam seed i ten sam prompt w tym samym modelu dają ten sam obraz. Po zmianie sceny w prompcie twarz i tak się zmienia, co pokazał test z Markiem (ten sam seed dla wszystkich scen). Używam go do:
- poprawek jednego słowa w udanym kadrze,
- porównań: ten sam seed z referencją i bez,
- powtarzalności w seriach, gdy model go ma (w tabeli wyżej).
Do utrzymania twarzy seed nie wystarcza. Robi to referencja.
Czego modele nie gwarantują
Nawet z referencją licz się z tym, że:
- twarz z profilu i z daleka dryfuje bardziej niż z przodu i z bliska,
- drobne detale ubrania (napisy na koszulce, wzór swetra, biżuteria) zmieniają się między ujęciami,
- dwie postacie w kadrze potrafią się "wymieszać": cechy jednej przechodzą na drugą,
- długi klip (20-30 s) ma więcej czasu na dryf niż 5-sekundowy,
- mina i wiek potrafią się przesunąć przy mocnej emocji w prompcie.
Dlatego w każdej serii zostawiam zapas na poprawki: zwykle dwa podejścia na ujęcie.
Ile to kosztuje
Przykład: postać do sześciu ujęć rolki, każde ujęcie 5 sekund.
| Etap | Model | Ilość | Koszt |
|---|---|---|---|
| Portret wzorcowy | Nano Banana Pro | 4 wersje | 4 × od 0,439 zł za obraz |
| Sceny z referencją | Nano Banana Pro | 6 scen × 2 | 12 × od 0,439 zł za obraz |
| Wideo z pierwszej klatki | Seedance 2.5 | 6 × 5 s × 2 podejścia = 60 s | 60 × od 1,51 zł za sekundę |
"Od" w cenie Seedance oznacza najniższą rozdzielczość, wyższe są droższe (stawki na stronie modelu). Koszt każdego zadania widzisz przed kliknięciem, a w API w polu estimated_cost. Nieudane generacje kosztują 0 zł. Pełne wyliczenia dla rolek są w tekście ile kosztuje rolka AI, a spójną postać w teledysku opisuję w poradniku teledysk AI.
Najczęstsze pytania
Jak zrobić tę samą postać w różnych obrazach AI?
Wygeneruj jeden portret wzorcowy i podawaj go jako obraz referencyjny (image_urls) w każdej kolejnej scenie, razem z tym samym opisem postaci. Sam opis i seed nie wystarczą, twarz będzie się zmieniać.
Który model najlepiej trzyma twarz?
Bez referencji w moim teście najlepiej trzymały ją Seedream 4.5, Photon i FLUX.2 [pro], a najsłabiej Nano Banana 2. Z referencją różnice się zmniejszają, więc wybieraj model po jakości obrazu i limicie referencji.
Ile obrazów referencyjnych mogę podać?
Zależy od modelu: GPT Image 2.5 do 16, Nano Banana Pro do 14, FLUX.2 [pro] do 8, a z modeli wideo Seedance 2.5 do 30 i Wan 3.0 do 10. Pełna tabela jest wyżej.
Czy seed wystarczy, żeby postać się nie zmieniała?
Nie. Seed daje ten sam obraz tylko przy tym samym prompcie. Po zmianie sceny twarz i tak się przesuwa.
Czy mogę użyć zdjęcia prawdziwej osoby?
Technicznie tak, w modelach, które to przyjmują, ale tylko za zgodą tej osoby. Część modeli ma filtry odrzucające realne twarze. Odrzucone zadanie w Jantarisie nic nie kosztuje.
Czy jest darmowy sposób na spójną postać?
W Jantarisie nie ma darmowego planu ani kredytów na start, płacisz od pierwszej generacji, a minimalne doładowanie to 40 zł. Saldo nie wygasa i możesz zacząć od kilku obrazów w Jantaris Studio.