Jak pisać prompty do obrazów AI - test krok po kroku
Jak pisać prompty do obrazów AI: struktura, słownik światła i obiektywów, napisy, seed i proporcje. Pięć promptów, ten sam seed i prawdziwe wyniki.
 Piotr Olszewski2026-10-0212 minEnglish
Dobry prompt do obrazu opisuje sześć rzeczy: co jest w kadrze, gdzie to stoi, jakie jest światło, jak patrzy aparat, w jakim stylu i w jakim formacie. Każde z tych pól, którego nie wypełnisz, wypełni za Ciebie generator obrazów AI, zwykle najbardziej oczywistą wersją. Niżej pokazuję to na własnym teście: ten sam seed, pięć coraz dłuższych promptów i obrazy z każdego kroku, a do tego proporcje, napisy i seedy. Wszystko zrobiłem na Z-Image Turbo, który w Jantarisie kosztuje 0,09 zł za obraz, więc takie ćwiczenie jest najtańszym sposobem na naukę.
Struktura promptu w sześciu polach
Zanim zacznę pisać, odpowiadam sobie na sześć pytań. Kolejność w prompcie ma znaczenie: modele zwykle mocniej trzymają się tego, co pada na początku.
| Pole | Pytanie | Przykład |
|---|---|---|
| Obiekt | Co jest najważniejsze w kadrze? | a red and white lighthouse |
| Otoczenie | Gdzie to jest, co dzieje się wokół? | on a rocky Baltic coast, waves crashing on the rocks |
| Światło i pora | Skąd pada światło, jaka pogoda? | at blue hour, light beam visible in the sea mist |
| Aparat | Z jakiej wysokości, jakim obiektywem? | low angle, 24mm wide lens, long exposure |
| Styl | Zdjęcie, ilustracja, plakat? | cinematic colour grading albo flat screen-printed colours |
| Format | Pion, poziom, kwadrat? | ustawiasz w polu proporcji, nie w prompcie |
Format ustawiam parametrem aspect_ratio albo przyciskiem w Studio, a nie słowami "pionowy kadr". Słowo w prompcie model może zignorować, parametr nie.
Test: jedna latarnia, pięć promptów
Wszystkie obrazy poniżej mają ten sam seed (20261002), tę samą rozdzielczość 1344x768 i 9 kroków. Zmieniałem tylko prompt. Generowałem lokalnie, tym samym modelem, który jest w katalogu Jantarisa jako Z-Image Turbo. Wszystkie prompty w teście są po angielsku.
Krok 1: sam obiekt
a lighthouse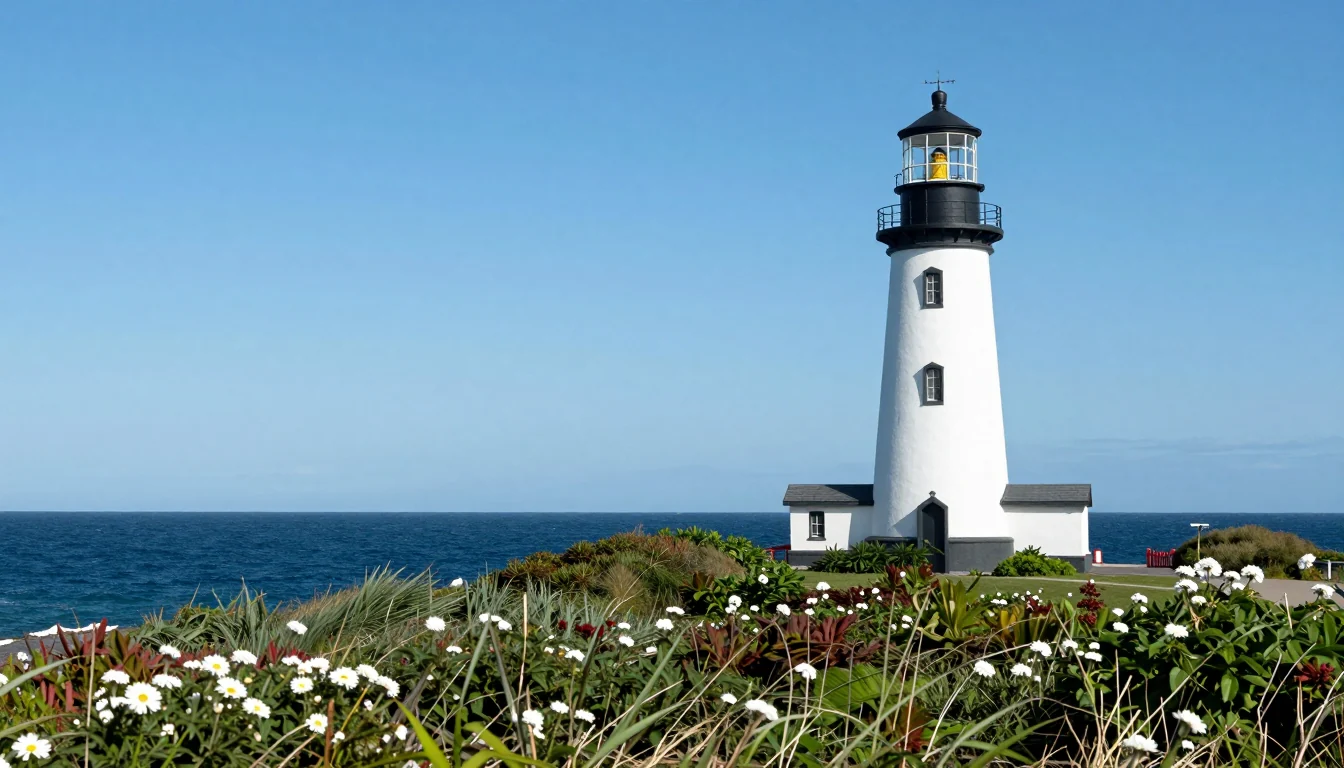
Dwa słowa dały pocztówkę: biała wieża z czarną kopułą, bezchmurne niebo w południe, stokrotki na pierwszym planie. Nic z tego nie zamawiałem. Tak wygląda "średnia latarnia" w głowie modelu i tak wygląda każdy prompt, który kończy się na obiekcie.
Krok 2: kolor i miejsce
a red and white lighthouse on a rocky Baltic coast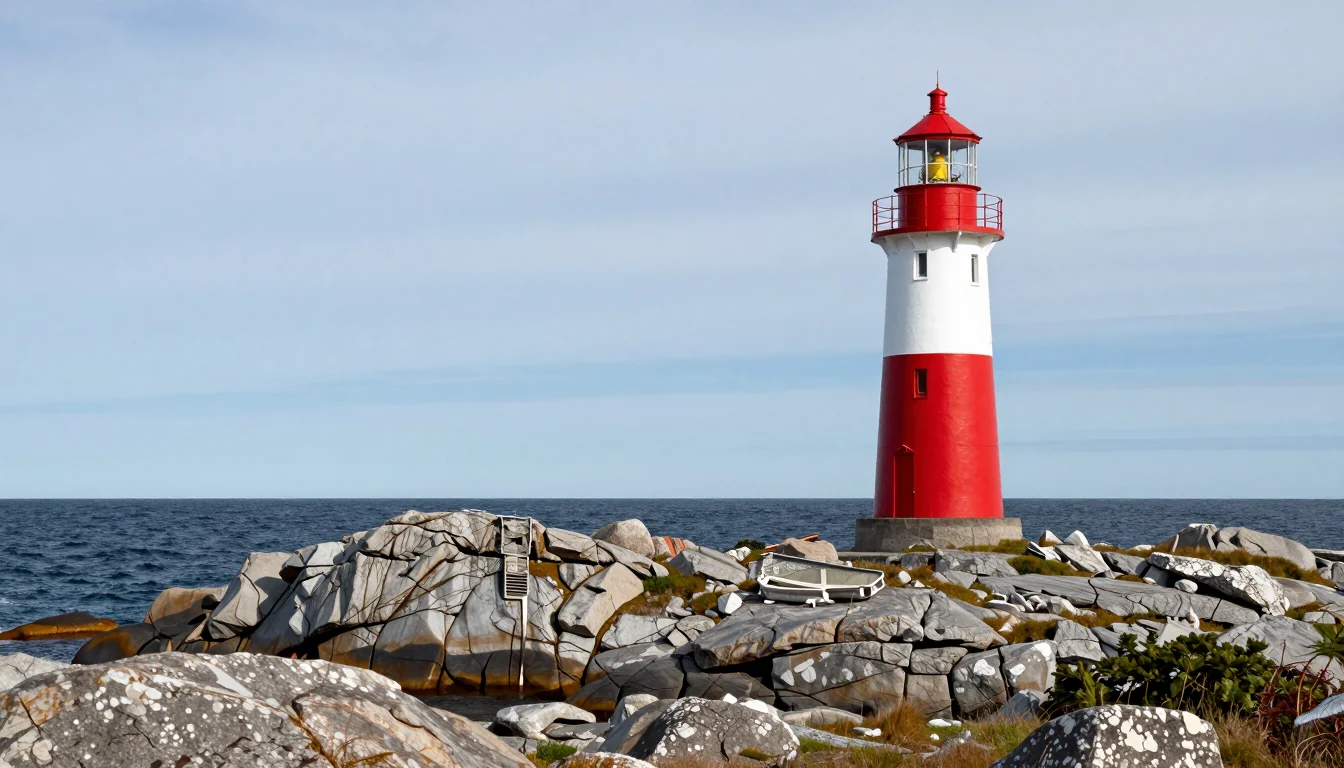
Wieża zrobiła się czerwona z białym pasem, kwiaty zamieniły się w granitowe głazy z porostami, niebo zszarzało, a na kamieniach pojawiła się mała łódka. Ciekawsze jest to, co zostało: latarnia nadal stoi w prawej trzeciej części kadru, a horyzont jest na tej samej wysokości. Przy tym samym seedzie i podobnym prompcie model trzyma ogólny układ.
Krok 3: pora dnia i akcja
a red and white lighthouse on a rocky Baltic coast at blue hour, waves crashing on the rocks, the light beam visible in the sea mist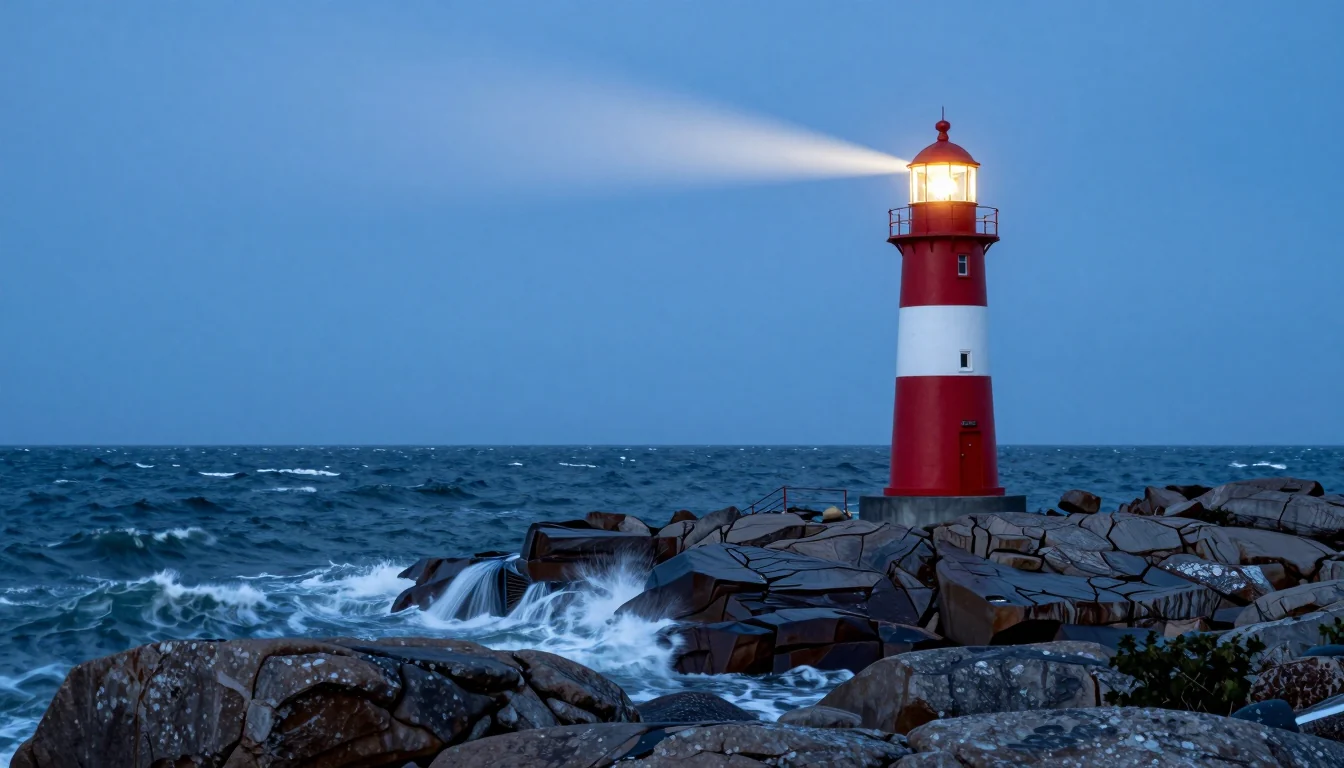
Największa zmiana w całej serii wynika z trzech słów "at blue hour". Paleta zrobiła się granatowa, lampa się zapaliła, snop światła idzie w lewo, a przy skałach pojawiły się bryzgi piany. Mgły prawie nie widać: snop jest narysowany na czystym niebie. To typowe, model realizuje najmocniejsze elementy opisu, a drobniejsze potrafi pominąć.
Krok 4: aparat i obróbka
a red and white lighthouse on a rocky Baltic coast at blue hour, waves crashing on the rocks, the light beam visible in the sea mist, low angle, 24mm wide lens, long exposure, cinematic colour grading
Tu widać, że słownik fotograficzny działa. "24mm wide lens" zmieścił w kadrze więcej morza, "long exposure" zamienił fale w rozmyte smugi, a "cinematic colour grading" przesunął kolory w stronę chłodnego turkusu. Za to "low angle" jest ledwo widoczny. Druga obserwacja: tym razem układ się rozjechał. Latarnia przeszła na lewą stronę, na osobną wysepkę, a snop świeci w prawo. Seed nie gwarantuje tej samej kompozycji, kiedy dopisujesz dużo nowych słów.
Krok 5: zmiana stylu
vintage 1950s travel poster of a red and white lighthouse on a rocky Baltic coast at blue hour, the light beam cutting through sea mist, flat screen-printed colours, bold simple shapes, no text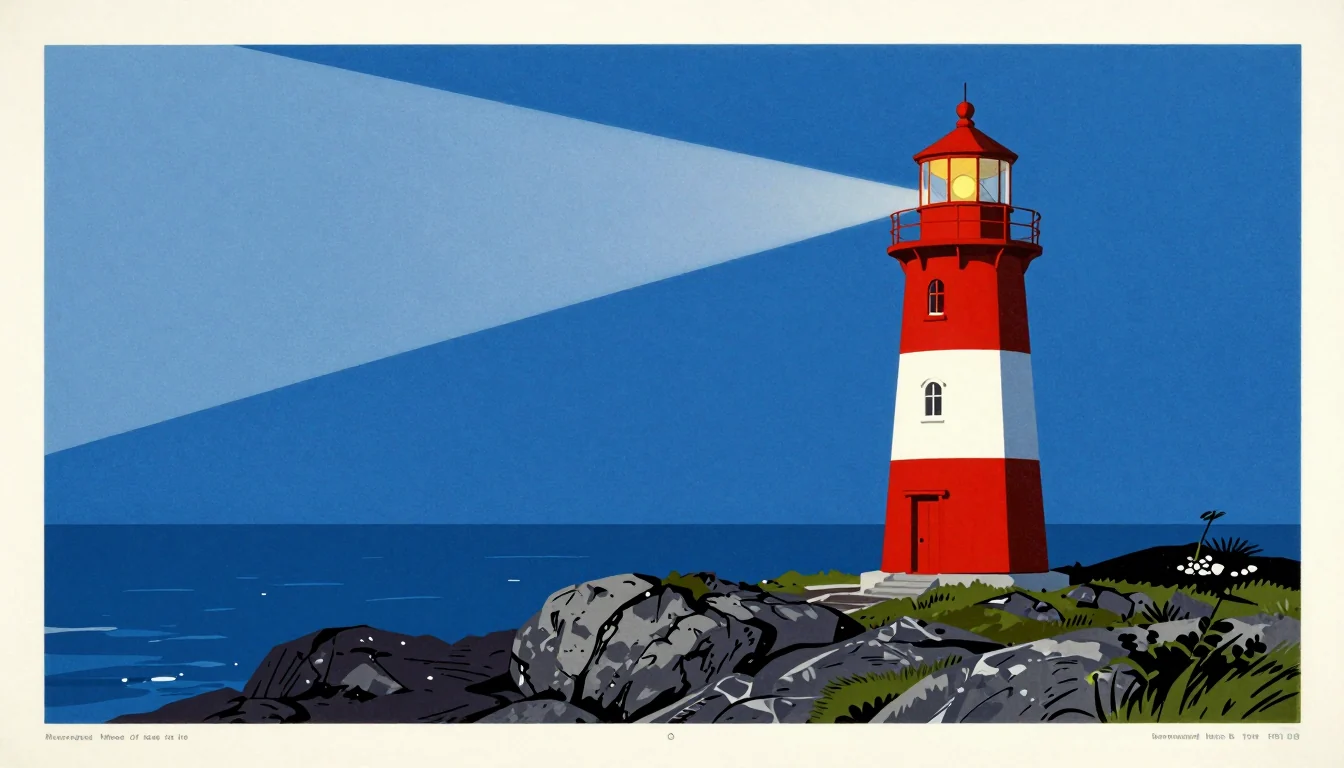
Styl wszedł w całości: płaskie kolory, kremowa ramka, snop jako geometryczny klin, morze bez fal. Ale przyjrzyj się dolnemu marginesowi. Po lewej i prawej stronie stoją drobne, nieczytelne znaki udające podpis drukarni, a na środku małe kółko. Prawdziwe plakaty turystyczne mają takie podpisy, więc model je dorysował, mimo "no text" na końcu. Zakaz w prompcie to słaby hamulec, bo sam wymienia rzecz, której nie chcesz.
Co z tego wynika dla Twoich promptów:
- Każde dopisane pole zmienia obraz bardziej niż dopisany przymiotnik. Pora dnia zmieniła więcej niż "cinematic".
- Dodawaj jedną grupę słów na raz i patrz, co się zmieniło. Pięć zmian naraz to pięć podejrzanych.
- Styl z silnymi skojarzeniami (plakat, okładka, magazyn) przynosi ze sobą elementy, o które nie prosisz, np. napisy.
- Ten sam seed trzyma układ kadru tylko przy małych zmianach. Po dopisaniu kilkunastu słów kompozycja może się przestawić.
Proporcje zmieniają kadr, nie tylko jego brzegi
Ten sam prompt i ten sam seed w trzech proporcjach:
macro product photo of a raw Baltic amber pendant with a tiny insect inclusion, lying on dark wet slate, a single warm backlight making the amber glow, shallow depth of field, high detail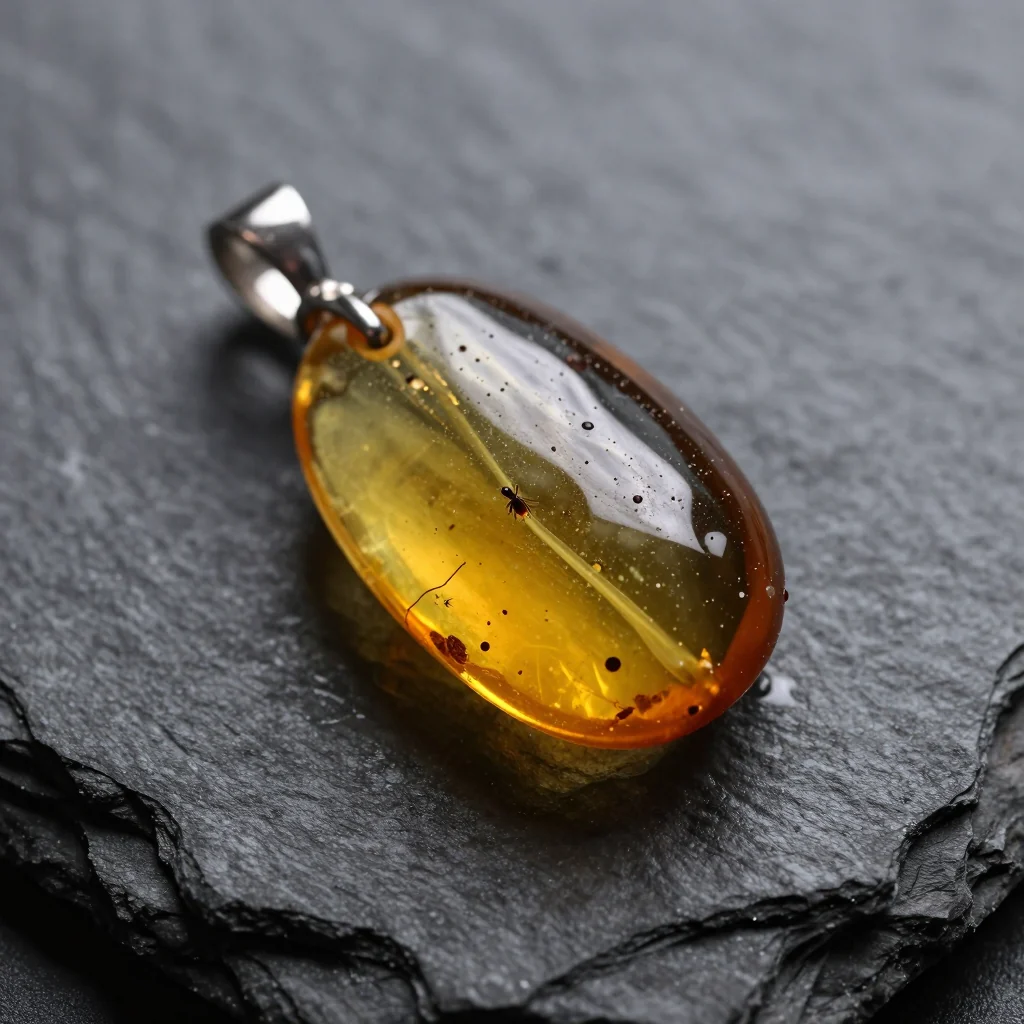
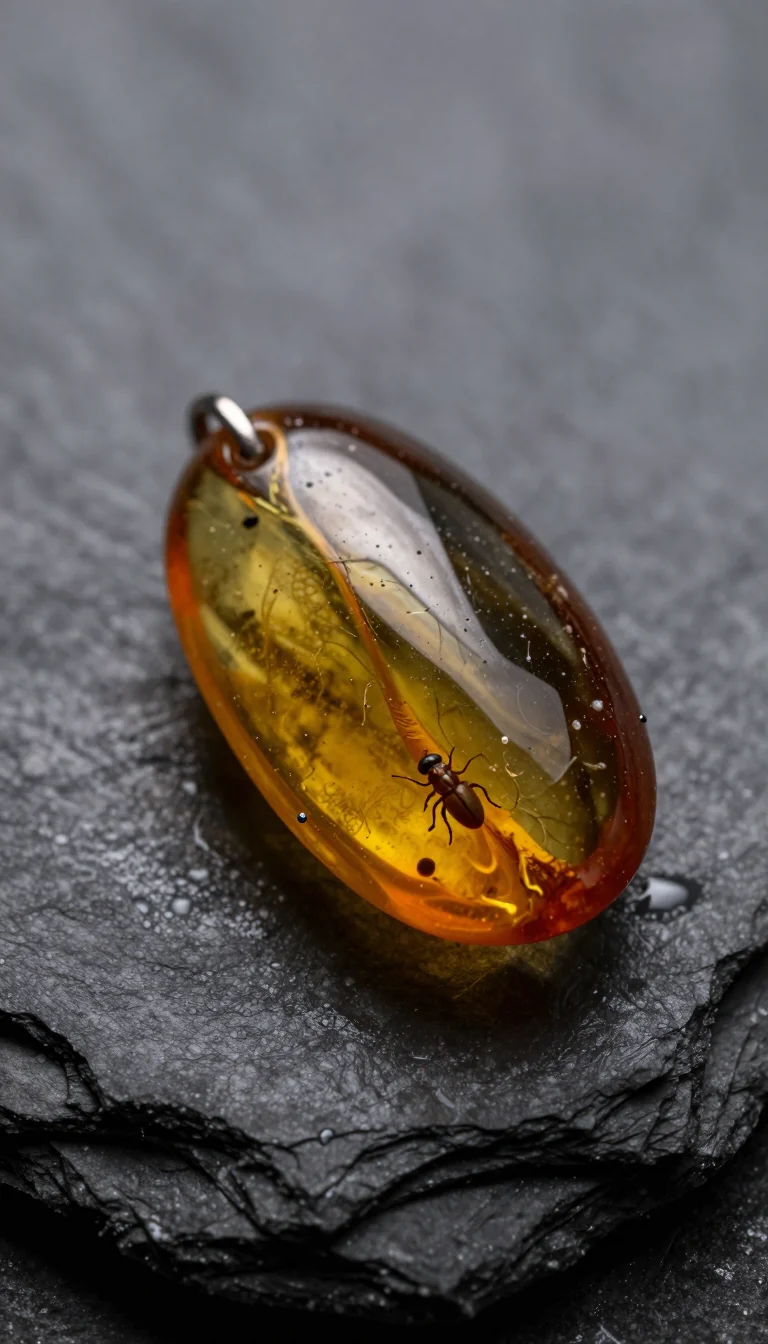

To nie jest jedno zdjęcie przycięte na trzy sposoby. W kwadracie owad w bursztynie przypomina małego pająka, w pionie to wyraźny chrząszcz, a w poziomie skrzydlaty owad i gałązka, do tego wisior dostał czarny rzemyk. Pion zostawił dużo rozmytego łupka nad wisiorem, co przydaje się w rolce, gdy na górze ma stanąć tekst. Dlatego proporcje ustawiam przed generowaniem, a nie przycinam gotowego obrazu, i nie przenoszę seeda między formatami w nadziei na ten sam wynik.
Napis na obrazie: cudzysłów i "exactly"
photo of a small coffee shop window at night, a hand-lettered chalkboard sign in the window reading exactly "FRESH BREW", warm interior light, rain drops on the glass
Tekst, który ma się pojawić, daję w cudzysłowie i dopisuję "exactly" albo "reading exactly". Napis "FRESH BREW" wyszedł bez błędu, z cieniem i krojem jak u szyldziarza, krople deszczu też są. Jedna rzecz poszła inaczej: zamiast tablicy kredowej w oknie model namalował litery wprost na szybie. Tekst w cudzysłowie dostał pierwszeństwo przed opisem przedmiotu, na którym miał stać.
Zasady, których się trzymam przy napisach:
- krótko, najlepiej 1-3 słowa na jeden napis,
- tekst w cudzysłowie, bez zmieniania wielkości liter między promptem a oczekiwanym wynikiem,
- każdy napis sprawdzam w powiększeniu 100%, zanim grafika pójdzie dalej,
- polskie znaki tylko w modelach, które je umieją. Z-Image Turbo w moim teście na promptowy.com napisał "ŽÓŁČ" zamiast "ŻÓŁĆ", a w porównaniu GPT Image 2.5, Nano Banana Pro i FLUX.2 pokazuję, które modele przechodzą polski szyld bez błędu.
Seed: po co i kiedy go ustawiać
Seed to liczba, od której model zaczyna losowanie szumu. Ten sam prompt z trzema seedami:
portrait of a fisherman in a yellow raincoat on a pier, overcast light, 85mm lens, realistic skin texture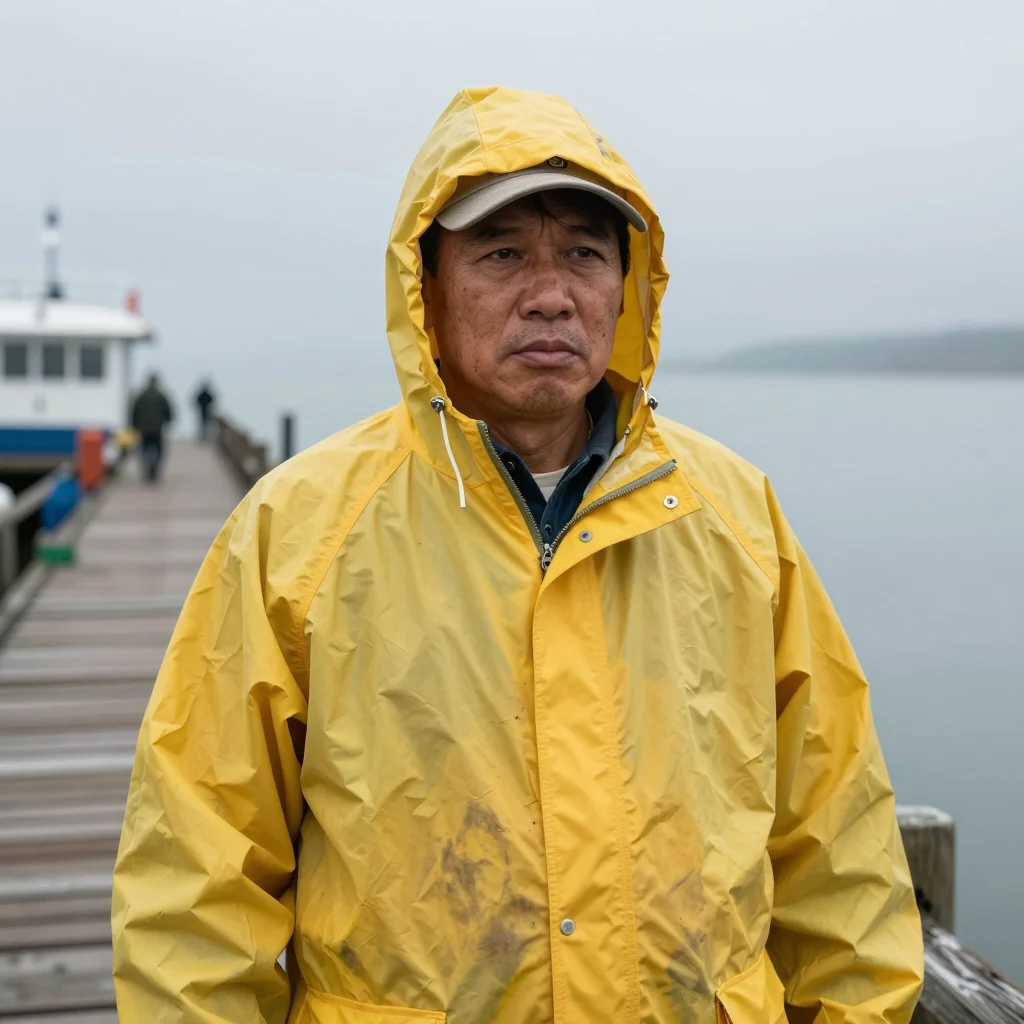

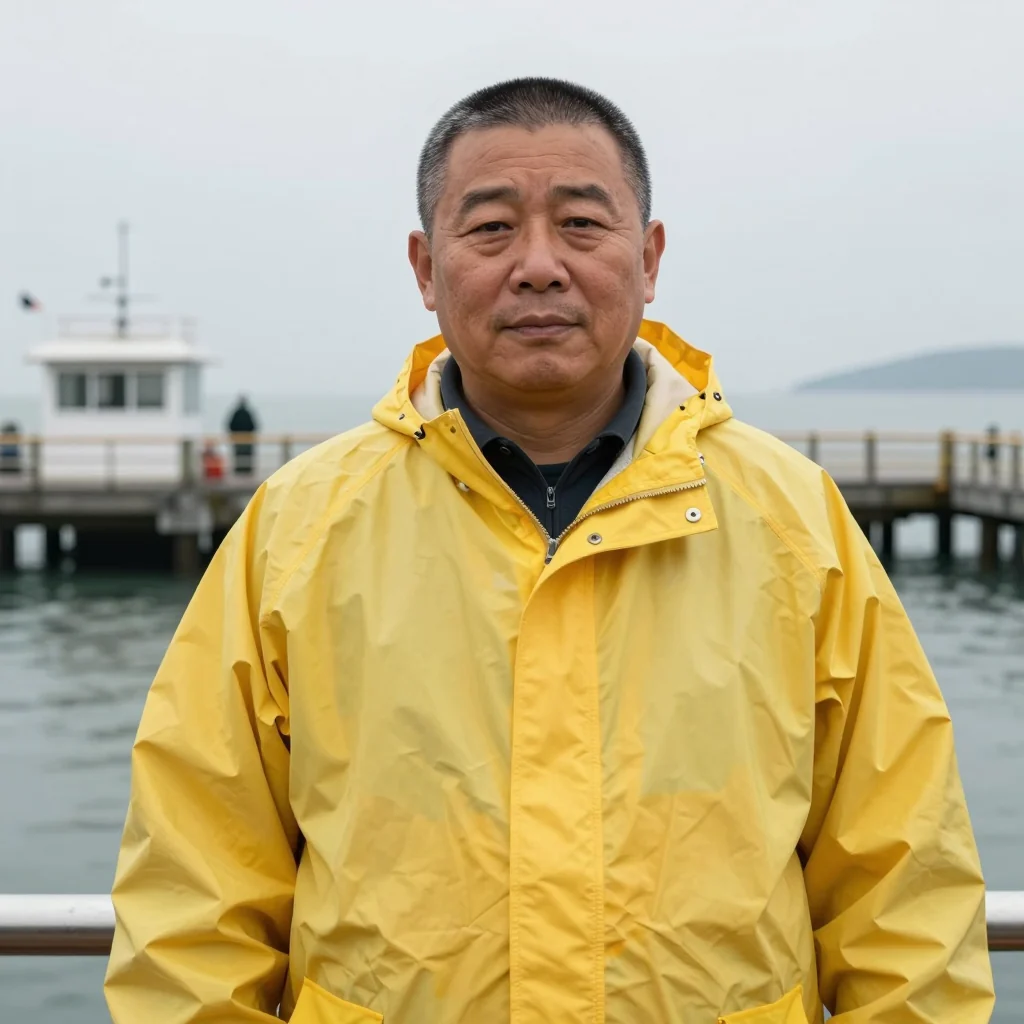
Trzy seedy to trzy różne zdjęcia: czapka pod kapturem i pomost uciekający w głąb, kaptur na głowie i kuter w tle, kaptur zdjęty i barierka. Opis zostaje spełniony w każdym, zmienia się wszystko, czego opis nie przesądza. Jest też wspólny mianownik: we wszystkich trzech wyszedł mężczyzna w średnim wieku o azjatyckich rysach. Prompt nie mówił nic o wieku ani wyglądzie, więc model wziął swój domyślny typ. Jeśli to dla Ciebie ważne, opisz to wprost.
Do czego seed przydaje się w praktyce:
- Poprawki jednego słowa. Masz udany kadr, zapisujesz seed i zmieniasz tylko kolor płaszcza. Przy drobnej zmianie układ zwykle zostaje (krok 2 w teście latarni), przy dużej może się rozjechać (krok 4).
- Powtarzalność. Ten sam prompt, seed, model i rozdzielczość dają ten sam obraz, co pomaga przy porównaniach.
- Wybór z wariantów. Generujesz kilka seedów, wybierasz najlepszy i od niego poprawiasz.
- Test jednego słowa. Ten sam seed z i bez "long exposure" pokazuje, co to słowo naprawdę robi w danym modelu.
W Jantarisie pole seed mają między innymi Z-Image Pro, FLUX.2 [max] i FLUX.1 Kontext [pro]. Z-Image Turbo w API i w Studio go nie przyjmuje, więc każdy obraz z niego jest losowy. Seedy w teście ustawiałem lokalnie.
Słownik: światło, obiektywy, style
Te określenia działają w większości modeli. Piszę je po angielsku, bo w takiej formie modele widziały je najczęściej w danych treningowych.
Światło
| Fraza | Efekt |
|---|---|
golden hour | ciepłe, niskie słońce, długie cienie |
blue hour | granatowe niebo tuż po zachodzie, zapalone światła |
overcast light | miękkie, równe światło bez ostrych cieni (portrety) |
single warm backlight | światło zza obiektu, kontur i prześwit |
hard flash | ostre cienie, styl zdjęć z imprezy albo mody |
neon light, wet street | kolorowe odbicia, klimat nocnego miasta |
Aparat i obiektyw
| Fraza | Efekt |
|---|---|
24mm wide lens | szeroki kadr, dużo otoczenia |
50mm lens | perspektywa zbliżona do oka |
85mm lens | portret, ściśnięte tło |
macro | detal z bliska, mała głębia ostrości |
shallow depth of field | rozmyte tło |
long exposure | rozmyta woda, smugi świateł |
low angle / top-down | z dołu / z góry |
Styl
| Fraza | Kiedy |
|---|---|
product photo on seamless background | packshot do sklepu |
35mm film photo, subtle grain | zdjęcie "analogowe" |
flat vector illustration, limited palette | ilustracja do bloga |
watercolor illustration | książeczka, zaproszenie |
vintage travel poster, screen-printed | plakat (licz się z pseudo-napisami) |
isometric 3D render | infografika, ikony |
Nazwy marek, magazynów i żyjących artystów to ryzyko. W moim lokalnym teście Z-Image Turbo, opisanym na promptowy.com, prośba o ilustrację "w stylu" konkretnego magazynu skończyła się dorysowaniem jego winiety z tytułem. Styl lepiej opisać słowami: kreska, paleta, faktura.
Typowe błędy
| Błąd | Co się dzieje | Poprawka |
|---|---|---|
| Sam obiekt, bez otoczenia | pocztówka z domyślnym tłem (krok 1) | dopisz miejsce, porę i światło |
| Lista przymiotników ("beautiful, stunning, 8k, masterpiece") | prawie żadnej zmiany | zamień na konkret: obiektyw, pora, materiał |
| Sprzeczności ("night, bright sunlight") | model wybiera jedno losowo | jedno źródło światła na prompt |
| Zakaz w prompcie ("no text") | zakazana rzecz i tak się pojawia (krok 5) | opisz, co ma być zamiast, albo użyj negative_prompt, jeśli model go ma |
| Format opisany słowami | model ignoruje "vertical" | ustaw aspect_ratio |
| Pięć zmian naraz | nie wiesz, co zadziałało | jedna grupa słów na próbę |
| Długi tekst na grafice | literówki | 1-3 słowa, resztę dodaj w edytorze |
Pole negative_prompt ma w Jantarisie tylko część modeli, np. Wan 2.7 Image i Qwen Image 3.0. Listę pól każdego modelu zwraca GET /v1/models/{id}.
Prompty po polsku czy po angielsku
Mój test był w całości po angielsku, więc nie mam własnych pomiarów, jak Z-Image Turbo reaguje na polskie prompty. Co mogę powiedzieć uczciwie:
- Słownik fotograficzny (obiektywy, światło, style) piszę po angielsku w każdym modelu. To terminy, które modele znają w tej formie.
- Napisy, które mają być po polsku, muszą być po polsku, ale wybierz do nich model, który obsługuje polskie znaki. Nano Banana Pro i GPT Image 2.5 w moich testach przeszły szyld "PIEKARNIA ŻÓŁĆ" bez błędu, Z-Image Turbo nie.
- Duże modele, takie jak Nano Banana Pro, rozumieją opis sceny po polsku. Praktyczne prompty w tym modelu zebrałem w tekście Nano Banana Pro po polsku.
- Jeśli myślisz po polsku, napisz opis po polsku, poproś model czatu o tłumaczenie na angielski i dopiero wtedy wyślij go do generatora.
Jak przećwiczyć to w Jantaris Studio
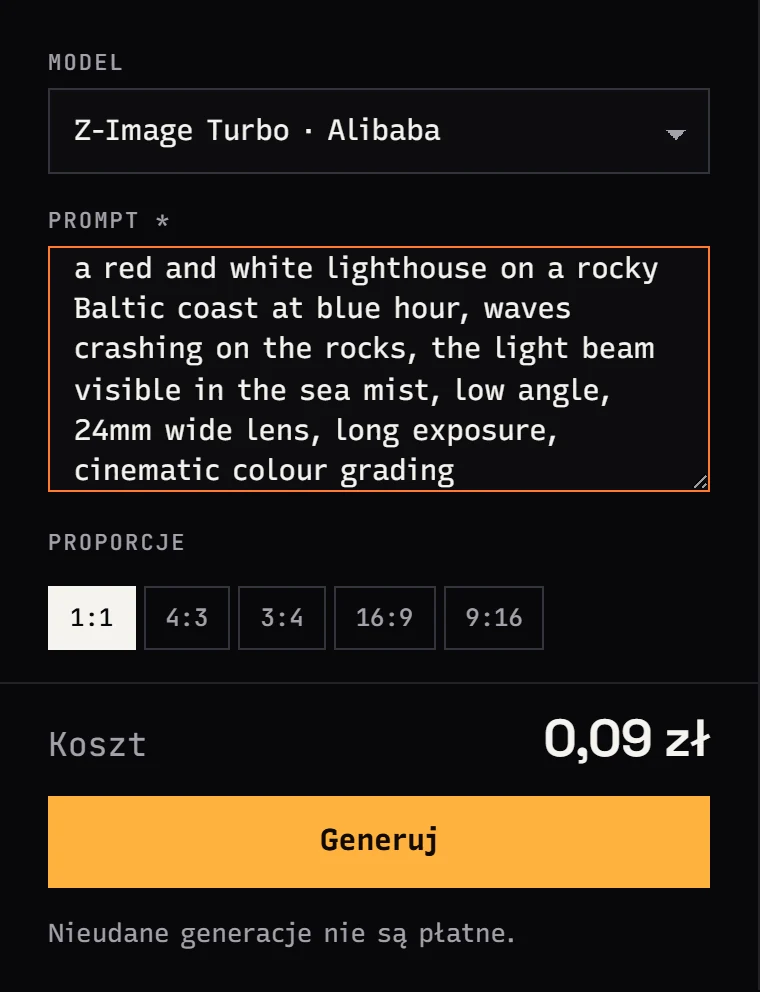
W Jantaris Studio wybierasz model, wklejasz prompt, ustawiasz proporcje i widzisz koszt przed wysłaniem. Z-Image Turbo ma pięć proporcji (1:1, 4:3, 3:4, 16:9, 9:16) i zwraca jeden obraz na zapytanie, więc do ćwiczeń z drabinką promptów jest wygodny i tani. Kiedy prompt jest gotowy, ten sam tekst wklejam do droższego modelu i porównuję. Nieudane generacje nie są płatne, a doładowanie zaczyna się od 40 zł przez BLIK, z fakturą VAT.
To samo przez API, z gotowym obrazem w odpowiedzi dzięki ?wait=60:
curl "https://jantaris.com/v1/generate?wait=60" \
  -H "Authorization: Bearer $JANTARIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "z-image",
    "input": {
      "prompt": "a red and white lighthouse on a rocky Baltic coast at blue hour, waves crashing on the rocks",
      "aspect_ratio": "16:9"
    }
  }'
Serię promptów z pliku, zapis plików i obsługę błędów w Pythonie opisałem w poradniku generowania obrazów przez API. Więcej o samym modelu, jego cenie i ograniczeniach: Z-Image Turbo po polsku. Jeśli z gotowego obrazu chcesz zrobić klip, zajrzyj do tekstu jak zrobić film AI ze zdjęcia, a prompty z ruchem kamery są w promptach do wideo AI.
Najczęstsze pytania
Jak długi powinien być prompt do obrazu?
Tyle, ile trzeba, żeby wypełnić sześć pól: obiekt, otoczenie, światło, aparat, styl, format. W moim teście najlepszy fotograficzny wynik dał prompt z kroku 4, około 35 słów. Z-Image Turbo przyjmuje do 1000 znaków, Z-Image Pro działa najlepiej na jednym akapicie 90-170 słów.
Dlaczego ten sam prompt daje za każdym razem inny obraz?
Bo za każdym razem losowany jest inny seed. Jeśli model ma pole seed, ustaw je, a dostaniesz powtarzalny wynik. Zmiana proporcji albo dużej części promptu i tak zmieni kompozycję.
Jak dodać napis do obrazu AI?
Daj tekst w cudzysłowie, dopisz "exactly" i trzymaj się 1-3 słów. Do polskich znaków wybierz model, który je obsługuje, np. Nano Banana Pro albo GPT Image 2.5, i zawsze sprawdź litery w powiększeniu.
Czy "no text" usuwa napisy z obrazu?
Nie zawsze. W moim teście plakat z "no text" dostał drobne pseudo-napisy na marginesie. Lepiej opisać, co ma być w tym miejscu, wybrać styl bez skojarzeń z drukiem albo użyć negative_prompt w modelach, które go mają.
Czy jest darmowy generator obrazów AI w Jantarisie?
Nie, Jantaris nie ma darmowego planu ani kredytów na start. Płacisz od pierwszego obrazu, najmniej 0,09 zł za obraz w Z-Image Turbo, minimalne doładowanie to 40 zł, saldo nie wygasa, a nieudane generacje kosztują 0 zł. Z-Image Turbo ma otwarte wagi, więc z mocną kartą graficzną możesz go też uruchomić u siebie.
Jaki model wybrać do nauki pisania promptów?
Najtańszy i szybki, bo uczysz się na serii prób. Ja ćwiczę na Z-Image Turbo, a gotowy prompt sprawdzam w droższym modelu. Ceny wszystkich modeli obrazu są w cenniku.